Warum bedeutet „alle drei Stichproben haben Labels“ nicht, dass das gesamte Subnetz riskant ist?
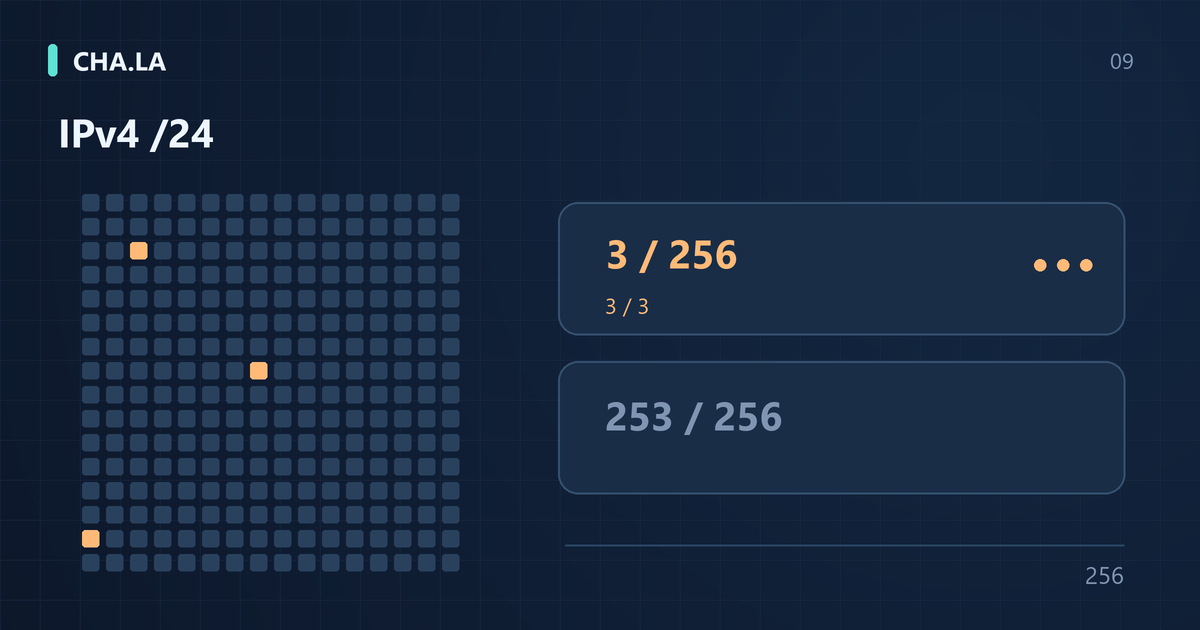
Angenommen, Sie sehen auf einer IP-Abfrage-Seite eine Zusammenfassung für ein /24-Subnetz: Kürzlich wurden nur 3 IPv4-Adressen beobachtet, und alle 3 tragen ein Risikolabel. Die Oberfläche zeigt dann möglicherweise „100 % markiert“ an. Diese Zahl wird leicht missverstanden, aber sie bedeutet nur, dass alle Adressen in der beobachteten Stichprobe markiert sind – nicht, dass alle 256 Adressen des /24-Subnetzes bösartig sind. Wir weisen ausdrücklich darauf hin, dass dies nur ein Rechenbeispiel ist und keine Messung eines realen Subnetzes darstellt. Bei einem Stichprobenanteil von 100 % ist der Zähler 3 beobachtete Adressen und der Nenner ebenfalls 3 beobachtete Adressen; die Division ergibt 100 %, aber der Nenner deckt die 253 unbeobachteten Adressen dieses /24 überhaupt nicht ab.
Dieser Irrtum entsteht, weil der „beobachtete Teil“ mit dem „Ganzen“ verwechselt wird. Viele Sicherheits-Backends, Threat-Intelligence-Plattformen oder Routing-Alarmoberflächen zeigen standardmäßig Einträge, die im gewählten Zeitfenster aufgetreten sind. Adressen außerhalb des Fensters, ohne Datenverkehr oder ohne Treffer durch Sensoren erscheinen weder im Zähler noch ändern sie den Wert von 100 %. Solange viele Adressen unbeobachtet bleiben, erlaubt der angezeigte Prozentsatz keinen Rückschluss auf das gesamte Subnetz. Leser sollten bei einem Labelanteil von 100 % zunächst prüfen, ob ein Hinweis wie „basierend auf aktuellen Beobachtungen“ oder „Stichprobenabdeckung“ vorhanden ist.
Anders gesagt: Dass diese 3 Adressen alle Labels tragen, belegt nur, dass die 3 kürzlich gesehenen Adressen Sicherheitsanmerkungen haben. Daraus lässt sich weder ableiten, dass das gesamte /24-Subnetz ein sehr hohes Risiko aufweist, noch umgekehrt beweisen, dass diese 3 zwangsläufig bösartige Angriffsquellen sind. Beispielsweise könnten diese 3 von einem Tor-Exit-Knoten stammen und in der Vergangenheit mehrfach durch Scans gemeldet worden sein, während die anderen 253 Adressen desselben /24 niemals eine Alarmierung ausgelöst haben. Wer „alle beobachteten Stichproben sind markiert“ als „das gesamte Subnetz ist markiert“ liest, verwechselt wenige Verhaltensweisen mit der Reputation des gesamten IP-Bereichs – genau diese zentrale Verzerrung soll dieser Artikel aufschlüsseln.
Warum /24 und nicht Klasse-C-Netz?
Nach der Einführung von Classless Inter-Domain Routing (CIDR) bei IPv4-Adressen bezeichnet /24 ein Netzpräfix aus den ersten 24 Bit; die restlichen 8 Bit bilden den Hostteil. Das Präfix umfasst daher 2 hoch 8, also 256 Adressen, von a.b.c.0 bis a.b.c.255. Traditionell wird ein /24 oft als Klasse-C-Netz bezeichnet, aber das ist eine historische Bezeichnung. Vor CIDR wurden IPv4-Adressen in Klassen eingeteilt; die Standardmaske eines Klasse-C-Netzes ist 255.255.255.0 und damit scheinbar identisch mit /24. Im modernen Routing- und Statistik-Kontext gibt es jedoch wichtige Unterschiede.
Laut RFC 4632 ist CIDR nicht mehr an die Grenzen der Klassen A/B/C gebunden; jede Präfixlänge kann angekündigt und aggregiert werden. Tatsächliche Routing-Präfixe sind oft kein sauberes /24. Beispielsweise kann eine Organisation ein /20 ankündigen, das 16 aufeinanderfolgende /24-Subnetze umfasst. Eine BGP-Routing-Aktualisierung oder ein RPKI-ROA kann eine längere oder kürzere Präfixlänge enthalten. Daher entspricht die Betrachtung eines /24 als unabhängige Netzgrenze nicht immer der realen Topologie. Dass benachbarte Adressen im selben /24 liegen, bedeutet auch nicht, dass sie sich im selben physischen Subnetz, beim selben Mandanten oder unter demselben Routenpräfix befinden.
Auf statistischer Ebene gibt es eine weitere häufige Verwechslung: Bei der traditionellen Subnetzberechnung beträgt die Anzahl nutzbarer Hosts in einem /24 254, weil .0 oft als Netzadresse und .255 oft als Broadcast-Adresse behandelt wird. In der Threat-Intelligence-Statistik, wenn die Abdeckung oder Label-Abdeckung des gesamten /24-Präfixes bewertet wird, muss der Nenner jedoch die vollständige CIDR-Adressmenge sein, also 256 Adressen einschließlich .0 und .255. Wird 254 als Nenner verwendet, wird die Abdeckung leicht überschätzt. Sollen alle 256 Adressen für eine Reputationsbewertung herangezogen werden, muss eindeutig die moderne CIDR-Semantik statt der traditionellen Klasse-C-Hostanzahl verwendet werden. Jede Aussage wie „Ein Klasse-C-Netz hat 254 IPs“ bezieht sich in der Regel auf die Anzahl nutzbarer Hosts und nicht auf die statistische Grundgesamtheit der Risikoabdeckung.
Abdeckung, Stichprobenanteil und bekannter Labelanteil des gesamten Bereichs
Wenn auf einer /24-Seite drei verschiedene Prozentwerte erscheinen, kommt es darauf an, den Nenner jeder Zahl zu klären. Schritt 1: Abdeckung. Angenommen, in diesem /24 wurden kürzlich nur 3 Adressen beobachtet. Der Nenner ist 256, der Zähler 3, also beträgt die Abdeckung 3 ÷ 256 = 1,171875 %. Sie beantwortet die Frage: „Welchen Anteil der Adressen dieses Präfixes haben wir in diesem Zeitraum überhaupt gesehen?“ – und nicht: „Wie viele Adressen sind problematisch?“ Ein niedriger Wert bedeutet nur wenig Beobachtung, nicht dass die übrigen Adressen sauber oder gefährlich sind.
Schritt 2: Labelanteil der beobachteten Stichprobe. Der Zähler ist die Anzahl der markierten unter den 3 beobachteten Adressen, der Nenner die 3 beobachteten Adressen. Wenn alle 3 markiert sind, ergibt sich 100 %. Er beantwortet die Frage: „Wie viele der wenigen gesehenen Stichproben tragen eine Risikoanmerkung?“ Dies ist ein bedingter Anteil, kein Anteil am gesamten Bereich. Seine Grenze besteht darin, dass Zähler und Nenner vom Beobachtungsfenster, den Datenquellen und der Aktualisierungshäufigkeit der Labels abhängen und nicht die Gesamtrisikoquote aller 256 Adressen darstellen können.
Der dritte Indikator ist der bekannte Labelanteil des gesamten Bereichs: Der Zähler ist 3 bekannte markierte Adressen, der Nenner 256, das ergibt 1,171875 %, etwa 1,17 %. In diesem Beispiel sind weitere 253 Adressen unbeobachtet; sie dürfen nicht als „geprüft, aber ohne Treffer“ behandelt werden. 3/256 bedeutet, dass 3 von 256 Adressen bekannt markiert sind; es darf nicht als „etwa 1,17 von 256“ formuliert werden. Auch dies ist eine Label-Abdeckung, keine echte Bösartigkeitsrate, da Labels selbst möglicherweise nur Hosting, VPN oder Tor beschreiben.
Unbekannte Adressen können nicht als sicher oder bösartig eingestuft werden
Die 253 nicht markierten Adressen müssen in verschiedene Zustände aufgeteilt werden, statt pauschal als „sicher“ oder „schuldig“ zu gelten. Die vier Kategorien – unbeobachtet, kein Treffer, Datenfehler, abgelaufen – haben in den Seitenanmerkungen unterschiedliche Bedeutung. Unbeobachtet bedeutet, dass kürzlich keine Sensoren, Abfragen oder Datenverkehrsereignisse diese Adressen gesehen haben. Kein Treffer bedeutet, dass zwar eine Abfrage erfolgte, die Datenbank aber keinen entsprechenden Eintrag enthält. Datenfehler bedeutet, dass die Abfrage aufgrund von Zeitüberschreitung, Formatproblemen oder nicht verfügbaren Upstream-Quellen kein Ergebnis lieferte. Abgelaufen bedeutet, dass früher ein Label vorhanden war, es aber wegen des abgelaufenen Zeitfensters oder ungültig gewordener Aufzeichnungen nicht mehr angezeigt wird.
Diese Unterschiede zu verstehen ist wichtig, um das Risiko einzuschätzen. Beispielsweise hat ein „Unbekannt“, das durch Zeitüberschreitungen bei RDAP-, BGP- oder RPKI-ROA-Abfragen entsteht, eine andere Aussagekraft als ein „Nicht beobachtet“, das niemals von Port-Scans getroffen wurde. Ersteres könnte eine vorübergehende Störung sein, Letzteres ist möglicherweise einfach nicht exponiert. In jedem Fall bedeutet „Unbekannt“ nicht gleich sicher. Nicht markierte Adressen als „verifiziert sicher“ zu bezeichnen unterschätzt das Risiko, sie als „potenziell bösartig“ zu bezeichnen überschätzt die Bedrohung. Der richtige Ansatz ist, den Link Datenquellen und Methodik auf der Seite zu prüfen, um Aktualisierungsfrequenz, Quellen der Labels, Deduplizierungsregeln und Zeitfenster zu bestätigen.
Bei der Risikobewertung sollten nicht markierte Adressen separat in einen Beobachtungsstatus eingeordnet werden, anstatt sie direkt in einen Bedrohungsscore einzubeziehen. Reife Betriebsteams verfolgen gleichzeitig Beobachtungsabdeckung, Anteil markierter Adressen und Aktualisierungszeitpunkte der Labels und lösen Alarme bei Datenbankausfällen oder unzureichender Abdeckung aus. Wenn beispielsweise in einem /24 alle 253 Adressen nicht beobachtet wurden und das Sicherheitsteam dies als null Risiko betrachtet, könnte es latente bösartige Infrastruktur übersehen; wenn es alle auf die schwarze Liste setzt, entstehen viele Fehlalarme. Zwischen unbekannten und bekannten negativen Daten zu unterscheiden ist der erste Schritt zur Erkennung der Reputation eines ganzen IP-Bereichs.
Beobachtungsstichproben können einen Auswahlbias aufweisen
Ob diese Stichproben repräsentativ sind, hängt von der Erfassungsmethode ab. Wenn die Stichproben aus Alarmen, Meldungen, IOCs oder aktiven Benutzerabfragen stammen, gelangen auffällige oder verdächtige Adressen leichter in die Sammlung, während unbeachtete Adressen seltener erscheinen. Man sollte zuerst verstehen, wie die Daten ins System gelangen, und nicht ohne Angaben zur Stichprobenziehung annehmen, dass sie zufällig aus dem gesamten Bereich ausgewählt wurden. Bei gleicher Stichprobengröße stützen Zufallsstichproben und durch Alarme ausgelöste Erfassung unterschiedliche Schlussfolgerungen.
Wenn der Erfassungskanal auf anomale Ereignisse ausgerichtet ist, kann die direkte Extrapolation des Anteils markierter Stichproben auf den gesamten Bereich das Risiko überschätzen; andere Erfassungsverzerrungen können Fehler in unterschiedliche Richtungen erzeugen. Drei Stichproben mit Labels beschreiben nur den Zustand dieser drei Stichproben in der aktuellen Quelle. Um Gesamtschätzungen, Konfidenzintervalle oder Fehlerspannen zu berichten, sind Stichprobendesign, Labeldefinitionen und Modellannahmen erforderlich; man kann nicht allein anhand der Zahl 100 % eine scheinbar präzise Sicherheitsaussage für den gesamten Bereich berechnen.
Deshalb betonen wir immer wieder, dass man nicht mit wenigen Stichproben Schlussfolgerungen über einen ganzen IP-Bereich ziehen sollte. Angreifer können einen kleinen Block gehosteter IPs mieten, um Scans durchzuführen, während die meisten Adressen im selben /24 regulären Cloud-Mietern gehören könnten; oder drei Hosts in einem /24 werden von einem Botnetz kontrolliert, während benachbarte Adressen unauffällig sind. Der Stichprobenbias macht einen 100-%-Labelanteil auf der Seite eher zu einer Warnmeldung als zu einer Risikowahrscheinlichkeit für den gesamten Bereich. Bei der Interpretation solcher Anteile sollte man die Erfassungsmethode, die Deduplizierungslogik für Ereignisse und das aktive Zeitfenster prüfen, um Auswahlverzerrungen nicht mit Gesetzmäßigkeiten der Grundgesamtheit zu verwechseln.
Zuerst zwischen Nutzungslabels und Verhaltensaufzeichnungen unterscheiden
Selbst wenn wenige Adressen tatsächlich Labels tragen, darf man nicht alle Labels mit böswilligen Eindringversuchen gleichsetzen. VPN, Tor, Proxy und Hosting sind Hinweise auf Nutzungsart oder Bereitstellungsweise, zum Beispiel könnte die Adresse eine Exit-IP eines öffentlichen VPN-Anbieters sein. VPN und Tor sind an sich legitime Datenschutzwerkzeuge, die täglich von vielen normalen Nutzern verwendet werden; auch Unternehmen leiten Traffic über Proxy-Exits weiter. Daher sind solche Labels eher „Infrastrukturmerkmale“ als eine „Qualifizierung bösartigen Verhaltens“.
Im Gegensatz dazu gehören Meldungen über bösartige Scans, Brute-Force-Versuche oder C2-Kommunikation zu verhaltensbasierten Labels, die üblicherweise von Sicherheitsgeräten oder Drittquellen stammen. Die Gewichtung und das Fehlalarmrisiko unterscheiden sich. Gehostete IPs werden häufig gleichzeitig als VPN, Proxy und Scanquelle markiert, weil Angreifer ebenfalls Cloud-Hosts oder Proxy-Exits mieten, doch diese Infrastruktur wird auch vielfach legitim genutzt; allein aus dem Hosting- oder Proxy-Status lässt sich nicht ableiten, dass eine Anfrage bösartig ist. Doppelte Quellen und historische Einträge dürfen nicht als unabhängige Beweise gelten: Wenn dieselbe Adresse von zehn Threat-Intelligence-Schnittstellen referenziert wird, sind das nicht zehn unabhängige Ereignisse, sondern wahrscheinlich nur verbreitete Kopien derselben Datenquelle, was zu Mehrfachzählungen führen kann. In IP als VPN oder Proxy erkannt: Fehlalarme überprüfen können Sie nachlesen, warum VPN- oder Proxy-Labels nicht direkt als Sperrgrundlage dienen sollten.
Im praktischen Betrieb sollte man Labeltyp, Ersterkennungszeit, Beweisquelle und Deduplizierungskennzeichen unterscheiden. Beispielsweise sollte eine Adresse von einem Hosting-Anbieter mit nur dem Label „Tor-Exit“ nicht gleich behandelt werden wie eine Adresse aus einem Domänencontroller-Alarm mit dem Label „Laterales-Bewegungs-Scanning“. Das Risiko der ersten liegt eher in schwer prüfbarem anonymem Traffic, die zweite ist direkt mit Anzeichen eines internen Eindringens verbunden. Wenn die Seite beide als „hohes Risiko“ einstuft und mit Prozentangaben darstellt, führt das Leser in die Irre, das gesamte /24 sperren zu müssen. Nur wenn man die Semantik der Labels versteht, kann man das Risiko eines Netzsegments in einem vernünftigen Rahmen halten.
Gleiches Netzsegment, gleiche ASN und gleicher Mandant sind nicht dasselbe
Ein /24-Segment enthält 256 IPv4-Adressen, von .0 bis .255, und nicht, wie oft gesagt, 254 nutzbare Host-Adressen. Dieser Unterschied hat historische Gründe: In frühen klassischen Netzen hatten Klasse-C-Adressen standardmäßig die Subnetzmaske 255.255.255.0, und Netzwerk- sowie Broadcast-Adresse konnten nicht an Hosts vergeben werden. In modernen CIDR-Bereitstellungen ist /24 nur eine Präfixlänge und legt nicht automatisch die Rollen von Netzwerk- und Broadcast-Adresse fest; in vielen Carrier- und Cloud-Umgebungen wird /24 jedoch weiterhin häufig als Zuteilungs- oder Verwaltungseinheit verwendet. Daher muss bei der Betrachtung eines /24-Segments der statistische Nenner alle 256 Adressen umfassen, nicht 254. Andernfalls wird die Stichprobenabdeckung überschätzt und der unbekannte Anteil unterschätzt.
Benachbarte Adressen beweisen keinen gemeinsamen Mandanten. Zwei IPs im selben /24 können völlig verschiedenen Kunden zugewiesen sein, zu verschiedenen virtuellen Maschinen desselben Cloud-Mandanten gehören oder zu unterschiedlichen Zeiten von verschiedenen Nutzern verwendet worden sein. Eine gleiche ASN besagt nur, dass diese Adressen über dasselbe autonome System angekündigt werden; dieses AS kann ein großer Cloud-Anbieter oder Carrier sein, der Tausende unabhängiger Kunden bedient. Ein gleiches BGP-Präfix bedeutet nur eine Aggregation in der Routingtabelle; die tatsächliche Zuteilung kann feiner sein, etwa wenn ein /20 in mehrere /24 aufgeteilt und verschiedenen Abteilungen oder Downstreams zugewiesen wird. Daher kann man nicht, weil eine IP als bösartig markiert ist, auf ein Risiko für andere IPs im selben Segment schließen.
Die tatsächliche BGP-Ankündigung kann /20 sein, oder es können spezifischere Präfixe existieren; /24 ist auf Reputationsseiten oft nur ein statistisches Fenster. Wenn Angriffsaktivitäten einige Adressen daraus betreffen, beweist das weder, dass die übrigen Adressen sicher noch dass sie bösartig sind. Über IP-Präfixe abfragen und BGP-Routen abfragen können Sie die auf der Seite angegebenen Routenbereiche und Beobachtungen abgleichen und anschließend über RDAP den Registrierungsbereich prüfen. Die verschiedenen Werkzeuge können unterschiedliche Objekte und Granularitäten darstellen; eine Routenaggregation darf nicht direkt als Mandantengrenze betrachtet werden.
Wie Zeitfenster das Profil verändern
Das Risikoprofil eines Adressbereichs hängt von Beobachtungen in einem festgelegten Zeitfenster ab. Angenommen, in den letzten 7 Tagen wurden nur 3 Adressen eines /24 beobachtet, alle 3 tragen Labels für schädliche Aktivitäten, und für die übrigen 253 liegen keine Beobachtungen vor. Dann beträgt die Beobachtungsabdeckung 3/256, also etwa 1,17 %. Der Labelanteil unter den beobachteten Adressen beträgt 100 %, der Anteil bekannter Markierungen am gesamten Bereich dagegen 1,17 %. Diese Rechnung setzt voraus, dass nur 3 Adressen beobachtet wurden. Allein aus 3 markierten und 253 unmarkierten Adressen lässt sich dieselbe Abdeckung nicht ableiten. Eine abgefragte Adresse ohne Treffer ist etwas anderes als eine nie beobachtete Adresse. Ob die übrigen Adressen sicher sind, lässt sich aus diesen Zahlen nicht bestimmen.
Das Zeitfenster beeinflusst den Anteil. Wenn ein Anbieter missbräuchliche Ressourcen kürzlich bereinigt hat, können bösartige IPs offline gehen und die Kennzeichnung verschwindet; wenn ein Mieter umzieht, kann eine zuvor markierte IP einem normalen Nutzer neu zugewiesen werden; wenn die Beobachtung pausiert oder die Datenquellen-Aktualisierung verzögert ist, sinkt die Stichprobengröße. Diese Veränderungen lassen den Stichprobenanteil zu einem bestimmten Zeitpunkt sauberer oder schmutziger erscheinen, bedeuten aber keine echte Risikoänderung. Beim Vergleich von Daten verschiedener Zeitpunkte muss daher sichergestellt werden, dass Zeitfenster und Aktualisierungszeit übereinstimmen.
Wir können nicht behaupten, welchen Anteil der Internet-IPs diese Seite abdeckt, da es keine einheitliche Beobachtungsgesamtheit gibt. Jedes Netzsegment-Profil, das auf einer kleinen Stichprobe basiert, ist nur eine lokale Momentaufnahme. Wenn Nutzer sehen, dass eine Kennzeichnung innerhalb eines bestimmten /24-Segments verschwindet, sollten sie prüfen, ob es neue Beobachtungsdatensätze für dieses Segment gibt und ob die Datenquellen aktualisiert wurden, statt direkt eine Sicherheitsverbesserung anzunehmen.
Betriebsprüfung: Zuerst die direkten Belege der Zieladresse ansehen
Nach Erhalt einer Warnung zuerst die Ereignisbelege der Ziel-IP selbst ansehen, z. B. zeitgestempelte Flow-Protokolle, Anwendungsanfragen, Sicherheitsgeräteaufzeichnungen und überprüfbare Listeneinträge. RDAP und BGP liefern Registrierungs- und Routing-Hintergrund, aber keine direkten Belege für bösartiges Verhalten; passive DNS-Zuordnungen müssen ebenfalls hinsichtlich Zeit und Zweck geprüft werden. Kennzeichnungen benachbarter IPs können nur als Kontext für weitere Untersuchungen dienen, ersetzen aber nicht die Belege der Zieladresse selbst, und allein aus ASN-Änderungen darf nicht auf einen Mieterwechsel geschlossen werden.
Wenige gekennzeichnete Nachbarn lösen nicht automatisch eine Sperrung aus. Angenommen, in einem /24-Segment sind 5 IPs als bösartig markiert; diese 5 IPs könnten Knoten derselben Angriffsgruppe sein oder jeweils kompromittierte Kunden verschiedener Nutzer. Wenn die Ziel-IP keinerlei Belege für bösartiges Verhalten aufweist und nur wegen bösartiger Nachbarn im selben Segment gesperrt wird, könnten normale Nutzer fälschlich getroffen werden. Es sollten Belege dokumentiert, die Stichprobenabdeckung angegeben, ein Prüfverantwortlicher benannt und regelmäßig überprüft werden.
Ein weiteres hypothetisches Szenario: In einem /20 werden in einem /24 drei IPs mit Verhaltenskennzeichnungen beobachtet, während 253 Adressen keine Beobachtungsdaten haben. Selbst wenn die drei Kennzeichnungen ähnlich erscheinen, können sie auf wiederholte Verbreitung aus derselben Quelle zurückgehen und nicht auf drei unabhängige Ereignisse. Der nächste Schritt ist, Herkunft und Zeitpunkt der Einträge sowie die Aufzeichnungen der Zieladresse selbst zu prüfen und die weiterhin unbekannte Mieterbeziehung zu belassen. Dies ist ein Beispiel zur Veranschaulichung der Beurteilungsreihenfolge und stellt keine Messung eines realen Netzsegments dar.
Was sollte man beim Einkauf vom Anbieter erfragen?
Beim Einkauf von Netzwerkdiensten oder IP-Informationen darf man sich nicht nur auf die vom Anbieter behauptete „Reinheit“ verlassen. Fragen Sie, was die Datenquellen sind: eigene Honeypots, Blacklists Dritter oder passive DNS; ob die Aktualisierung in Echtzeit, täglich oder wöchentlich erfolgt; wie groß der Abdeckungsnenner ist, ob er alle 256 Adressen umfasst; und ob konkrete Einträge zur Verifizierung exportiert werden können. Kann der Anbieter diese Details nicht liefern, ist sein „Reinheits“-Versprechen nicht glaubwürdig.
Akzeptieren Sie keine Garantie für „hundertprozentig saubere“ IPs. In jedem Netztyp können früherer Missbrauch oder Probleme durch einen gemeinsamen Internetzugang auftreten: Geräte in privaten Netzen können mit Malware infiziert werden, und als „nativ“ beworbene Adressen können von Mietern missbraucht werden. Anbieter können Statistiken aus ihren Beobachtungen bereitstellen, daraus aber keine absolute Sicherheit garantieren. Fragen Sie nach dem Korrekturverfahren, der erwarteten Bearbeitungszeit und einer Beschwerdemöglichkeit. Unterscheiden Sie dabei Leistungszusagen von überprüften Fakten.
Kategorien wie Residential, Mobile und Hosting beschreiben unterschiedliche Netzwerkhintergründe; aus der Kategorie allein lässt sich nicht ableiten, wer eher bösartig ist. Dynamische Zuweisung, geteilte Nutzung, Datenabdeckung und Zielservice-Richtlinien beeinflussen die tatsächliche Erfahrung. Beim Lesen von Residential-, ISP- und Rechenzentrums-IPs im Vergleich sollten Marketing-Labels in überprüfbare Zugangs-, Nutzungs- und Zuweisungsbedingungen zerlegt und dann Abnahmekriterien für konkrete Geschäftsszenarien vereinbart werden.
Wie stellt man Netzsegment-Profile dar, ohne irrezuführen?
Bei der Gestaltung einer Netzsegment-Profiloberfläche sollten Entwickler gleichzeitig die Gesamtzahl der Adressen (z. B. 256 bei /24), die Zahl der beobachteten Adressen, die Zahl der gekennzeichneten Adressen und die Zahl der unbekannten Adressen anzeigen. So ist die Stichprobenabdeckung intuitiv erkennbar. Beispiel: 3 beobachtete Adressen, 3 gekennzeichnete, 253 unbekannte – anzeigen als „Abdeckung 1,17 %, bekannte Kennzeichnungen 1,17 %“. Zeigen Sie nicht nur den Anteil bösartiger Kennzeichnungen, das würde Nutzer irreführen.
Farblegenden sollten verschiedene Zwecke und Verhaltensweisen unterscheiden, z. B. normal, bösartig, verdächtig, keine Daten. Keine Daten dürfen nicht mit sicher verwechselt werden; Unbekanntes kann grau dargestellt werden. Verwenden Sie für IPv6 kein /24-Rasterdiagramm, bei dem eine Zelle eine IP repräsentiert, denn ein IPv6-/64 hat 2^64 Adressen und lässt sich nicht auf 256 Zellen abbilden. Stattdessen können aggregierte Statistiken oder Stichproben-Visualisierungen genutzt werden.
Mit dem CIDR-Rechner lässt sich schnell die Anzahl der Adressen eines Präfixes bestätigen. Bei der Darstellung von IPv6 sollte der Fehler vermieden werden, dass „Nachbarn innerhalb eines /64 demselben Mieter entsprechen“. Beispielsweise wird ein /64 in IPv6 normalerweise einem Subnetz zugewiesen, aber innerhalb desselben Subnetzes können mehrere Container oder virtuelle Maschinen existieren.
Häufige Fragen und Prüfliste
Ob eine Anomalie einer Adresse Nachbarn beeinflusst, hängt davon ab, ob der Zieldienst Regeln nach Einzel-IP, Präfix, ASN oder anderen Signalen umsetzt; man kann nicht einfach behaupten, welche Methode die meisten Websites verwenden. Null Kennzeichnungen bedeuten nur, dass unter bestimmten Daten und Regeln kein Treffer vorliegt, kein Sicherheitsnachweis. Alle 256 Adressen zu beobachten heißt nicht, dass alle gekennzeichnet sind; selbst wenn jede Adresse eine bestimmte Kennzeichnung trägt, ist nicht bewiesen, dass dieselbe Person das gesamte Netzsegment kontrolliert. Abdeckung, Kennzeichnungsbedeutung und Nutzerzuordnung sind drei unabhängige Fragen.
Die Prüfliste umfasst: Gesamtzahl der Adressen, Zahl der beobachteten Adressen, Zahl der gekennzeichneten Adressen, Zahl der unbekannten Adressen, Zeitfenster, Datenquellen, BGP-Präfix, RDAP-Registrierungsinformationen. Erst nach Bestätigung dieser Punkte Entscheidungen treffen. Ziehen Sie keine Schlüsse aus nur einer Zahl.
Zur weiteren Lektüre können IP-Reputation prüfen: Risikowerte und Sperrlisten verstehen und RDAP, ASN, BGP und RPKI: IP-Daten richtig einordnen genutzt werden. Diese beiden Leitfäden helfen zu verstehen, wie direkte und indirekte Belege einer IP gesammelt und interpretiert werden, und vermeiden, eine kleine Stichprobe als Reputation des gesamten IP-Segments zu betrachten.