Trois échantillons tous étiquetés : pourquoi cela ne signifie pas que toute la plage est à risque ?
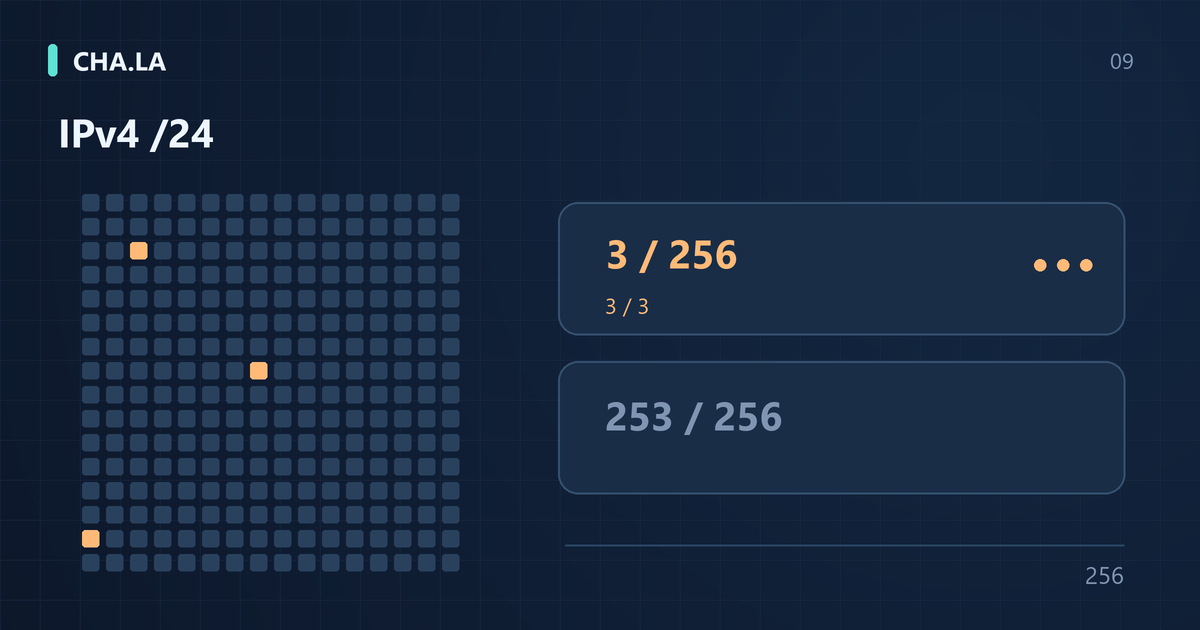
Imaginons que sur une page de Recherche d’adresse IP vous voyiez une vue récapitulative d'une plage /24 : seules 3 adresses IPv4 ont été observées récemment, et toutes les 3 portent des étiquettes de risque. L'interface peut afficher « 100 % étiquetées ». C'est un chiffre facile à mal interpréter, car il signifie seulement que toutes les adresses de l'échantillon observé sont étiquetées, et non que les 256 adresses du /24 sont malveillantes. Nous précisons qu'il s'agit d'un exemple de calcul, pas d'une mesure réelle sur une plage spécifique. Le ratio de 100 % a pour numérateur 3 adresses observées et pour dénominateur 3 adresses observées ; en divisant l'un par l'autre on obtient 100 %, mais ce dénominateur ne couvre pas les 253 adresses non observées du /24.
Cette confusion vient du fait de prendre « la partie observée » pour « le tout ». Beaucoup de consoles de sécurité, de plateformes de renseignement sur les menaces ou d'alertes de routage affichent par défaut les entrées apparues dans une fenêtre temporelle donnée. Les adresses hors fenêtre, sans trafic ou non détectées par les capteurs n'apparaissent pas au numérateur et ne modifient pas ce ratio de 100 %. Tant qu'un grand nombre d'adresses reste non observé, le pourcentage affiché ne permet pas d'inférer quoi que ce soit sur toute la plage. Lorsque vous voyez un taux d'étiquetage de 100 %, vérifiez d'abord s'il y a une mention comme « basé sur des observations récentes » ou « couverture de l'échantillon ».
Autrement dit, que ces 3 adresses soient toutes étiquetées signifie seulement ceci : les 3 adresses vues récemment ont des annotations de sécurité. On ne peut pas en déduire que tout le /24 est à très haut risque, ni prouver que ces 3 adresses sont forcément des sources d'attaques malveillantes. Par exemple, ces 3 adresses peuvent venir d'un nœud de sortie Tor, signalées plusieurs fois par le passé pour des scans, alors que les 253 autres adresses du même /24 n'ont jamais déclenché d'alerte. Si l'on prend « tous les échantillons observés sont étiquetés » pour « toute la plage est étiquetée », on juge à tort la réputation de toute la plage IP à partir de quelques comportements. C'est précisément le biais central que cet article veut démonter.
Pourquoi parler de /24 et non de réseau de classe C ?
Depuis l'adoption du routage interdomaine sans classe (CIDR) pour IPv4, un /24 signifie que les 24 premiers bits constituent le préfixe réseau et les 8 bits restants la partie hôte. Ce préfixe contient donc 2 puissance 8, soit 256 adresses, allant de a.b.c.0 à a.b.c.255. Par habitude, on appelle souvent un /24 un réseau de classe C, mais c'est un héritage historique. Avant le CIDR, IPv4 était découpé en classes, et le masque par défaut d'un réseau de classe C était 255.255.255.0, ce qui correspond en apparence au /24. Mais dans le contexte du routage moderne et des statistiques, la distinction est importante.
Selon la RFC 4632, le CIDR ne repose plus sur les frontières de classes A/B/C : n'importe quelle longueur de préfixe peut être annoncée et agrégée. Dans la pratique, les préfixes routés ne sont souvent pas des /24 bien nets. Par exemple, une organisation peut annoncer un /20, qui couvre 16 /24 consécutifs. Une mise à jour BGP ou un enregistrement ROA RPKI peut avoir une longueur de préfixe plus longue ou plus courte. Par conséquent, considérer un /24 comme une frontière de réseau indépendante ne correspond pas toujours à la topologie réelle. Que des adresses voisines se trouvent dans le même /24 ne signifie pas qu'elles appartiennent au même sous-réseau physique, au même locataire ou au même préfixe routé.
Il existe une autre confusion fréquente au niveau statistique : dans le calcul de sous-réseau traditionnel, un /24 a 254 hôtes utilisables, car .0 est souvent considéré comme adresse réseau et .255 comme adresse de diffusion. Mais dans les statistiques de renseignement sur les menaces, pour évaluer la couverture ou le taux d'étiquetage d'un préfixe /24 entier, le dénominateur doit être l'ensemble complet des adresses CIDR, soit 256 adresses, y compris .0 et .255. Si l'on prend 254 comme dénominateur, on surestime légèrement la couverture. Et si l'on sort les 256 adresses pour évaluer leur réputation, il faut utiliser la sémantique CIDR moderne et non le nombre d'hôtes de la classe C traditionnelle. Quand on dit « une classe C a 254 IP », cela désigne généralement le nombre d'hôtes utilisables, et non la population statistique pour la couverture du risque.
Couverture, ratio d'échantillon et ratio d'étiquettes connues sur toute la plage
Quand une page /24 affiche trois pourcentages différents, l'essentiel est de comprendre le dénominateur de chaque chiffre. Première étape : la couverture. Supposons que ce /24 n'ait que 3 adresses observées récemment. Le dénominateur est 256 adresses, le numérateur est 3 adresses, la couverture est donc 3 ÷ 256 = 1,171875 %. Elle répond à la question « quelle proportion des adresses de ce préfixe avons-nous réellement vue pendant cette période ? », et non « combien d'adresses posent problème ? ». Un chiffre bas signifie seulement que le volume d'observations est faible, et non que les autres adresses sont propres ou dangereuses.
Deuxième étape : le ratio d'étiquettes de l'échantillon observé. Le numérateur est le nombre d'adresses étiquetées parmi les 3 adresses observées, le dénominateur est 3 adresses observées. Si les 3 sont étiquetées, le résultat est 100 %. Cela répond à la question « parmi les quelques échantillons déjà vus, combien portent une annotation de risque ? ». C'est un ratio conditionnel, pas un ratio sur toute la plage. Sa limite est que le numérateur et le dénominateur dépendent de la fenêtre d'observation, des sources de données et de la fréquence de mise à jour des étiquettes. Il ne peut pas représenter le taux de risque global des 256 adresses.
Le troisième indicateur est le ratio d'étiquettes connues sur toute la plage : le numérateur est 3 adresses connues étiquetées, le dénominateur est 256, ce qui donne 1,171875 %, soit environ 1,17 %. Dans cet exemple, 253 autres adresses n'ont pas été observées ; on ne peut pas les traiter comme ayant été vérifiées sans résultat. 3/256 signifie que sur 256 adresses, 3 sont connues et étiquetées, ce qui ne s'écrit pas « environ 1,17 sur 256 ». Cela reste une couverture d'étiquettes, pas un taux réel de malveillance, car les étiquettes peuvent aussi décrire un hébergement, un VPN ou Tor.
Les adresses inconnues ne peuvent être classées ni comme sûres ni comme malveillantes
Les 253 adresses non étiquetées doivent être réparties en différents états, et non regroupées sous les termes « sûres » ou « coupables ». Non observées, sans correspondance, échec de données et expirées ont des sens différents dans les annotations de la page. Non observées signifie qu'aucun capteur, aucune requête ni aucun événement de trafic n'a vu ces adresses récemment. Sans correspondance signifie qu'elles ont été interrogées mais que la base de données n'a pas d'entrée correspondante. Échec de données signifie que la requête n'a pas abouti en raison d'un délai dépassé, d'un format invalide ou d'une source en amont indisponible. Expirées signifie qu'il y avait autrefois une étiquette, mais qu'elle n'est plus affichée en raison du dépassement de la fenêtre temporelle ou de l'invalidité de l'enregistrement.
Comprendre ces distinctions est important pour que les lecteurs puissent évaluer les risques. Par exemple, une adresse qui renvoie un délai d'attente lors d'une requête RDAP, BGP ou RPKI ROA produit une « inconnue » avec une fiabilité différente d'une adresse « non observée » qui n'a jamais été touchée par un scan de port. La première peut être une panne temporaire, la seconde peut simplement ne pas être exposée. Mais dans tous les cas, « inconnue » ne signifie pas sûre. Dire qu'une adresse non étiquetée est « vérifiée comme sûre » sous-estime le risque, tandis que dire qu'elle est « potentiellement malveillante » le surestime. La bonne approche consiste à consulter le lien Sources de données et méthodologie sur la page pour vérifier la fréquence de mise à jour des données, la source des étiquettes, les règles de déduplication et la fenêtre temporelle.
Lors de l'évaluation des risques, il convient de classer séparément les adresses non étiquetées dans un état à surveiller, plutôt que de les inclure directement dans un score de menace. Une équipe opérationnelle mature suit simultanément la couverture d'observation, la proportion d'étiquettes et l'heure de mise à jour des étiquettes, et déclenche des alertes en cas de défaillance de la base de données ou de couverture insuffisante. Par exemple, si 253 adresses d'un /24 ne sont pas observées, et qu'une équipe de sécurité les considère comme à risque nul, elle risque de passer à côté d'une infrastructure malveillante latente ; si elle les met toutes sur liste noire, elle générera de nombreuses fausses alertes. Distinguer les inconnues des données négatives connues est la première étape pour identifier la réputation IP de tout un bloc.
Les échantillons observés peuvent présenter un biais de sélection
La représentativité de ces échantillons dépend de la méthode de collecte. Si les échantillons proviennent d'alertes, de signalements, d'IOC ou de requêtes actives des utilisateurs, les adresses anormales ou suspectes ont plus de chances d'entrer dans l'ensemble, tandis que les adresses non surveillées apparaissent moins souvent. Il faut d'abord comprendre comment les données entrent dans le système, et ne pas supposer par défaut qu'elles sont tirées au hasard sur l'ensemble du bloc en l'absence de description de l'échantillonnage. Avec le même nombre d'échantillons, les conclusions tirées d'un échantillonnage aléatoire et d'une collecte déclenchée par des alertes ne sont pas les mêmes.
Si les canaux de collecte sont biaisés vers les événements anormaux, extrapoler directement la proportion d'étiquettes de l'échantillon à l'ensemble du bloc peut surestimer le risque ; d'autres biais de collecte peuvent produire des erreurs dans des directions différentes. Trois échantillons tous étiquetés ne décrivent que l'état de ces trois échantillons dans la source actuelle. Pour rapporter une estimation globale, un intervalle de confiance ou une marge d'erreur, il faut préciser le plan d'échantillonnage, la définition des étiquettes et les hypothèses du modèle, et on ne peut pas se contenter du chiffre de 100 % pour calculer une conclusion de sécurité apparemment précise pour tout le bloc.
C'est pourquoi nous insistons à plusieurs reprises sur le fait qu'il ne faut pas tirer de conclusion sur tout un bloc IP à partir d'un petit nombre d'échantillons. Un attaquant peut louer un petit bloc d'IP d'hébergement pour lancer des scans, alors que la plupart des adresses du même /24 appartiennent à des locataires cloud légitimes ; ou trois hôtes d'un /24 sont contrôlés par un botnet, tandis que les adresses voisines sont intactes. Le biais d'échantillonnage fait que le taux d'étiquetage de 100 % sur la page ressemble davantage à un rappel d'alerte qu'à une probabilité de risque pour tout le bloc. En interprétant de tels ratios, le lecteur doit vérifier la méthode de collecte des données, la logique de déduplication des événements et la fenêtre temporelle active, afin de ne pas confondre le biais de sélection avec une loi générale.
Distinguer d'abord les étiquettes d'usage des enregistrements de comportement
Même si quelques adresses portent effectivement des étiquettes, toutes ne doivent pas être assimilées à une intrusion malveillante. VPN, Tor, proxy, hébergement sont des indices d'usage ou de mode de déploiement ; par exemple, cette adresse peut être une IP de sortie utilisée par un fournisseur de VPN public. VPN et Tor sont en eux-mêmes des outils de confidentialité légitimes ; de nombreux utilisateurs ordinaires les utilisent quotidiennement pour accéder à Internet, et les entreprises font également transiter leur trafic par des sorties proxy. Ces étiquettes relèvent donc davantage de « caractéristiques d'infrastructure » que d'une « qualification de comportement malveillant ».
En revanche, les signalements de scans malveillants, les tentatives de force brute ou les communications C2 relèvent d'étiquettes comportementales, généralement issues d'équipements de sécurité ou de sources tierces. Leur pondération et leur risque de faux positifs diffèrent. Les IP d'hébergement sont souvent étiquetées à la fois comme VPN, proxy et source de scan, car les attaquants louent aussi des machines cloud ou des sorties de proxy, mais ces infrastructures ont aussi de nombreux usages légitimes ; le statut d’hébergement ou de proxy ne suffit pas à établir qu’une requête est malveillante. Les sources dupliquées et les entrées historiques ne doivent pas être traitées comme des preuves indépendantes : si une même adresse est citée par dix interfaces de renseignement, cela ne représente pas dix événements indépendants, mais probablement des copies propagées d'une même source, ce qui fausse le comptage. Vous pouvez consulter IP détectée comme VPN ou proxy : vérifier un faux positif pour comprendre pourquoi les étiquettes VPN ou proxy ne peuvent pas servir directement de motif de blocage.
En exploitation réelle, il faut distinguer le type d'étiquette, la date de première détection, la source de preuve et l'identifiant de déduplication. Par exemple, une adresse provenant d'un fournisseur d'hébergement et portant uniquement l'étiquette « sortie Tor » ne doit pas être traitée de la même manière qu'une adresse issue d'une alerte de contrôleur de domaine et portant l'étiquette « scan de mouvement latéral ». Le risque de la première tient surtout au trafic anonyme difficile à auditer, tandis que la seconde est directement liée à des signes d'intrusion interne. Si une page classe les deux comme « risque élevé » et l'affiche sous forme de pourcentage, elle induit le lecteur en erreur en lui faisant croire que tout le /24 doit être bloqué. Comprendre la sémantique des étiquettes permet de maintenir le risque d'un segment réseau dans des limites raisonnables.
Un même segment réseau, un même ASN et un même locataire ne sont pas la même chose
Un segment /24 contient 256 adresses IPv4, de .0 à .255, et non les 254 adresses d'hôtes utilisables souvent citées. Cette différence tient à des raisons historiques : dans les anciens réseaux par classes, une adresse de classe C avait un masque de sous-réseau par défaut de 255.255.255.0, et l'adresse réseau ainsi que l'adresse de diffusion ne pouvaient pas être attribuées à des hôtes. Dans les déploiements CIDR modernes, /24 n'est qu'une longueur de préfixe et n'implique pas automatiquement de rôles d'adresse réseau ou de diffusion ; pourtant, chez de nombreux opérateurs et environnements cloud, un /24 reste souvent utilisé comme unité d'allocation ou de gestion. Ainsi, lorsqu'on observe un segment /24, le dénominateur statistique doit être l'ensemble des 256 adresses, et non 254. Sinon, on surestime la couverture de l'échantillon et on sous-estime la part inconnue.
Des adresses adjacentes ne prouvent pas qu'elles appartiennent au même locataire. Deux adresses IP dans le même /24 peuvent être attribuées à des clients totalement différents, ou appartenir à des machines virtuelles distinctes d'un même locataire cloud, ou encore être utilisées par des utilisateurs différents à des moments différents. Un ASN identique indique seulement que ces adresses sont annoncées via le même système autonome, qui peut être un grand fournisseur de cloud ou un opérateur desservant des milliers de clients indépendants. Un même préfixe BGP ne représente qu'une agrégation dans la table de routage ; l'allocation réelle peut être plus fine, par exemple un /20 découpé en plusieurs /24 attribués à différents services ou clients en aval. Ainsi, le fait qu'une adresse IP soit signalée comme malveillante ne permet pas de déduire que les autres adresses IP du même bloc présentent un risque.
Une annonce BGP réelle peut être un /20, et des préfixes plus spécifiques peuvent également exister ; dans les pages de réputation, le /24 n'est souvent qu'une fenêtre statistique. Si une activité malveillante implique quelques-unes de ces adresses, cela ne prouve ni que les autres adresses sont sûres ni qu'elles sont malveillantes. Vous pouvez consulter la Recherche de préfixes IP et les Recherche de routes BGP pour vérifier la plage de routage indiquée sur la page et les observations, puis examiner la plage enregistrée via RDAP. Les différents outils peuvent présenter des objets et des granularités différents ; il ne faut pas assimiler directement une agrégation de routage à une frontière entre locataires.
Comment la fenêtre temporelle modifie le profil
Le profil de risque d’un bloc dépend des observations recueillies dans une fenêtre temporelle définie. Supposons que seules 3 adresses d’un /24 aient été observées au cours des 7 derniers jours, que les 3 portent une étiquette d’activité malveillante et que les 253 autres n’aient aucun enregistrement d’observation. La couverture est alors de 3/256, soit environ 1,17 %. Le taux d’étiquetage parmi les adresses observées est de 100 %, tandis que la part de marquages connus sur l’ensemble du bloc est de 1,17 %. Ce calcul suppose que seules 3 adresses ont été observées. On ne peut pas déduire la même couverture du seul fait que 3 adresses sont étiquetées et 253 ne le sont pas. Une adresse interrogée sans correspondance n’est pas une adresse jamais observée, et ces chiffres ne permettent pas de déterminer si les autres sont sûres.
La fenêtre temporelle influe sur les proportions. Si un fournisseur a récemment nettoyé des ressources abusives, les IP malveillantes peuvent être retirées et les étiquettes disparaître ; si un locataire migre, une IP précédemment marquée peut être réattribuée à un utilisateur normal ; si l'observation est suspendue ou si la mise à jour des sources de données est retardée, la taille de l'échantillon diminue. Ces variations peuvent faire paraître les proportions plus propres ou plus sales à un moment donné, sans que cela reflète un changement réel du risque. Par conséquent, lorsque vous comparez des données à différents moments, vérifiez que la fenêtre temporelle et l'heure de mise à jour sont cohérentes.
Nous ne pouvons pas prétendre couvrir un certain pourcentage des IP d'Internet, car il n'existe pas d'ensemble d'observation universel. Tout profil de segment de réseau basé sur un petit échantillon n'est qu'un instantané partiel. Lorsque vous constatez la disparition d'étiquettes dans un segment /24, vérifiez si de nouveaux enregistrements d'observation existent et si les sources de données ont été mises à jour, plutôt que de conclure à une amélioration de la sécurité.
Dépannage opérationnel : examinez d'abord les preuves directes de l'adresse cible
Après avoir reçu une alerte, examinez d'abord les preuves d'événements pour l'IP cible elle-même, comme les journaux de flux horodatés, les requêtes applicatives, les enregistrements des dispositifs de sécurité et les entrées de listes vérifiables. RDAP et BGP fournissent un contexte d'enregistrement et de routage, pas une preuve directe d'activité malveillante ; les associations DNS passives doivent être vérifiées en termes de temps et d'usage. Les étiquettes des IP voisines ne servent que de contexte pour une enquête plus approfondie ; elles ne remplacent pas les preuves de l'adresse cible elle-même, et on ne peut pas déduire un changement de locataire uniquement à partir de variations d'ASN.
Un petit nombre de voisins étiquetés ne déclenche pas automatiquement un blocage. Supposons que dans un segment /24, 5 IP soient marquées comme malveillantes ; ces 5 IP peuvent être des nœuds d'une même organisation d'attaque ou des clients distincts compromis. Si l'IP cible ne présente aucune preuve de comportement malveillant, la bloquer simplement parce que des voisins dans le même segment sont malveillants risque de pénaliser des utilisateurs légitimes. Vous devez consigner les preuves, indiquer le taux de couverture de l'échantillon et désigner un responsable de la révision pour un réexamen périodique.
Prenons un autre scénario hypothétique : dans un /20, un /24 contient 3 IP observées avec des étiquettes de comportement, et 253 adresses sans données d'observation. Même si les trois étiquettes semblent similaires, elles peuvent provenir de la propagation répétée d'une même source plutôt que de trois événements indépendants. L'étape suivante consiste à vérifier l'origine des entrées, les horodatages et les enregistrements de l'adresse cible elle-même, tout en gardant les relations de locataires inconnues. Ceci est un exemple illustrant l'ordre de jugement, pas une mesure d'un segment réel.
Quelles questions poser à un fournisseur lors d'un achat ?
Lors de l'achat de services réseau ou de données de renseignement sur les IP, ne vous fiez pas seulement à la « pureté » annoncée par le fournisseur. Demandez quelles sont les sources de données : honeypots maison, listes noires tierces ou DNS passif ? Quelle est la fréquence de mise à jour : temps réel, quotidienne ou hebdomadaire ? Quel est le dénominateur de couverture, inclut-il les 256 adresses ? Les entrées spécifiques peuvent-elles être exportées pour vérification ? Si le fournisseur ne peut pas fournir ces détails, sa promesse de « pureté » n'est pas crédible.
N’acceptez pas de garantie de « pureté à 100 % ». Tout type de réseau peut présenter un historique d’abus ou des problèmes liés à une sortie partagée : les appareils d’un réseau résidentiel peuvent être infectés par un logiciel malveillant, et des adresses vendues comme « natives » peuvent être détournées par leurs locataires. Un fournisseur peut présenter des statistiques fondées sur ses observations, mais celles-ci ne garantissent pas une sécurité absolue. Demandez la procédure de correction, le délai prévu et le canal de contestation, en distinguant les engagements du service des faits vérifiés.
Les classifications résidentielle, mobile et hébergée décrivent des contextes réseau différents ; on ne peut pas déduire directement de la catégorie laquelle est plus sujette à des activités malveillantes. L'allocation dynamique, l'usage partagé, la couverture des données et les politiques du service cible influencent l'expérience réelle. Lorsque vous lisez IP résidentielle, hébergée chez un FAI ou de datacenter ?, décomposez les étiquettes marketing en conditions vérifiables d'accès, d'usage et d'allocation, puis convenez de critères d'acceptation pour des scénarios métier spécifiques.
Comment présenter un profil de segment réseau sans induire en erreur ?
Lors de la conception d'une interface de profil de segment réseau, affichez simultanément le nombre total d'adresses (par exemple 256 pour un /24), le nombre d'adresses observées, le nombre d'adresses étiquetées et le nombre d'adresses inconnues. Cela montre clairement le taux de couverture de l'échantillon. Par exemple, si 3 adresses sont observées, 3 étiquetées et 253 inconnues, affichez « couverture 1,17 %, étiquettes connues 1,17 % ». N'affichez pas uniquement le pourcentage d'étiquettes malveillantes, cela induirait les utilisateurs en erreur.
La légende des couleurs doit distinguer les différents usages et comportements, par exemple : normal, malveillant, suspect, sans données. « Sans données » ne doit pas être confondu avec « sûr » ; utilisez le gris pour l'inconnu. N'utilisez pas une grille /24 de 256 cases représentant chacune une IP pour visualiser IPv6, car un /64 IPv6 contient 2^64 adresses, impossibles à mapper sur 256 cases. Utilisez plutôt des statistiques agrégées ou une visualisation par échantillonnage.
Utilisez un Calculateur CIDR pour confirmer rapidement le nombre d'adresses d'un préfixe. Pour IPv6, évitez de suggérer à tort que « des voisins dans un /64 équivalent à un locataire ». Par exemple, en IPv6, un /64 est généralement alloué à un sous-réseau, mais ce sous-réseau peut contenir plusieurs conteneurs ou machines virtuelles.
Questions fréquentes et liste de vérification
L'anomalie d'une adresse affecte-t-elle ses voisins ? Cela dépend des règles mises en œuvre par le service cible : par IP unique, préfixe, ASN ou autres signaux ; on ne peut pas affirmer sans preuve quelle approche la plupart des sites adoptent. Zéro étiquette signifie seulement qu'aucune correspondance n'a été trouvée avec des données et règles spécifiques, pas que c'est sûr. Observer les 256 adresses ne signifie pas qu'elles sont toutes étiquetées ; même si chaque adresse porte une certaine étiquette, on ne peut pas prouver qu'une même personne contrôle tout le segment. La couverture, la signification des étiquettes et l'attribution à un utilisateur sont trois questions indépendantes.
La liste de vérification comprend : nombre total d'adresses, nombre d'adresses observées, nombre d'adresses étiquetées, nombre d'adresses inconnues, fenêtre temporelle, sources de données, préfixe BGP, informations d'enregistrement RDAP. Confirmez ces éléments avant de prendre une décision. Ne concluez pas à partir d'un seul chiffre.
Pour approfondir, consultez Réputation IP : comprendre les scores et listes de blocage et RDAP, ASN, BGP et RPKI : comprendre les données d’une IP. Ces deux guides vous aideront à comprendre comment collecter et interpréter les preuves directes et indirectes d'une IP, afin d'éviter de prendre un petit échantillon pour la réputation d'un segment entier.