3つのサンプルすべてにラベルが付いているのに、なぜセグメント全体にリスクがあるとは言えないのでしょうか?
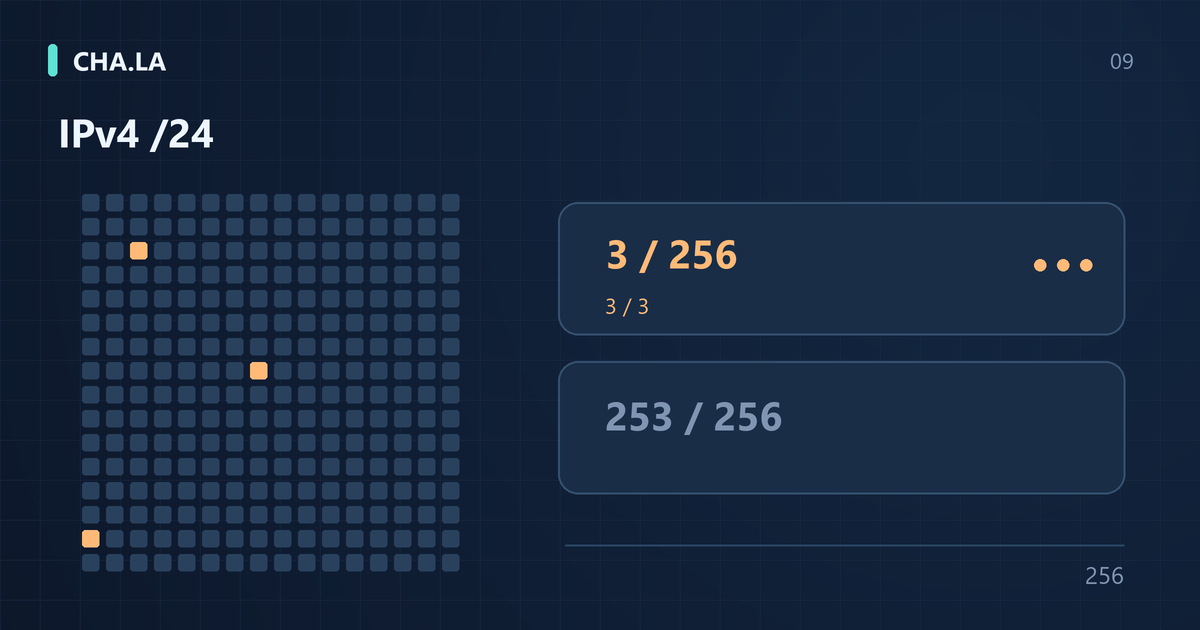
ある IPアドレス検索 ページで/24セグメントのサマリービューを表示しているとします。最近3つのIPv4アドレスのみが観測され、その3つすべてにリスクラベルが付いている場合、画面には「100% マーク済み」と表示されるかもしれません。これは誤解しやすい数値ですが、観測サンプル内の全アドレスにラベルが付いていることを示すだけで、/24全体の256アドレスすべてが悪意のあるものだという意味ではありません。これは実際のセグメントの測定結果ではなく、計算例であることを明確にします。サンプル比率100%の分子は観測された3アドレス、分母も観測された3アドレスで、割ると100%になりますが、分母にはこの/24で未観測の253アドレスが含まれていません。
この誤解は「観測された部分」を「全体」と捉えてしまうことに起因します。多くのセキュリティバックエンド、脅威インテリジェンスプラットフォーム、ルーティングアラート画面は、指定された時間枠内に現れたエントリをデフォルトで表示します。枠外の、トラフィックのない、センサーにヒットしなかったアドレスは分子にも現れず、100%という比率を変えることもありません。未観測のアドレスが多数残っている限り、ページ上のパーセンテージはセグメント全体を推測する力を持ちません。読者は100%のラベル比率を見たとき、まず「最近の観測に基づく」や「サンプルカバレッジ」といった背景説明があるか確認すべきです。
言い換えれば、この3つのアドレスすべてにラベルが付いていることは、最近見られたこれら3つのアドレスにセキュリティ注釈があることを示すだけです。それを/24セグメント全体のリスクが極めて高いと外挿したり、逆にこの3つが必ず悪意のある攻撃源だと証明したりすることはできません。例えば、この3つはすべてあるTor出口ノードからのもので、過去に何度もスキャン報告されたかもしれませんが、同じ/24内の残り253アドレスは一度もアラートを出していない可能性があります。「観測サンプルすべてにラベル」を「セグメント全体にラベル」と捉えると、少数の行動をセグメント全体のIPレピュテーションと誤判定してしまいます。これが本稿で解き明かす中心的なバイアスです。
なぜ /24 と書くのか、Cクラスネットワークではないのか?
IPv4アドレスはクラスレスドメイン間ルーティングの導入後、/24は先頭24ビットがネットワークプレフィックス、残り8ビットがホスト部分を表すため、このプレフィックスは2の8乗すなわち256個のアドレスを含み、範囲はa.b.c.0からa.b.c.255までです。伝統的に/24をCクラスネットワークと呼ぶ習慣がありますが、これは歴史的な呼び名です。CIDR以前は、IPv4はクラスで分割され、Cクラスネットワークのデフォルトマスクは255.255.255.0であり、これは表面的には/24と同じですが、現代のルーティングや統計の文脈では重要な違いがあります。
RFC 4632 によると、CIDRはA/B/Cクラスの境界に依存せず、任意のプレフィックス長をアナウンスおよび集約できます。実際のルーティングプレフィックスは整った/24ではないことが多く、例えばある組織は/20をアナウンスするかもしれません。これは16個の連続する/24にまたがり、BGPルート更新やRPKI ROAのプレフィックス長はより長いか短い場合があります。したがって、/24を独立したネットワーク境界と見なすことは、必ずしも実際のトポロジーと一致しません。隣接アドレスが同じ/24に現れても、それらが同じ物理サブネット、同じテナント、または同じルートプレフィックスの下にあるとは限りません。
統計面ではもう一つのよくある混同があります。従来のサブネット計算では/24の使用可能なホスト数は254です。なぜなら、.0はネットワークアドレス、.255はブロードキャストアドレスとして扱われることが多いからです。しかし、脅威インテリジェンス統計で/24プレフィックス全体のカバレッジやラベルカバレッジを評価する場合、分母にはCIDRの完全なアドレス集合、すなわち256個(.0と.255を含む)を用いるべきです。254を分母にするとカバレッジがわずかに過大評価されます。また、256個すべてのアドレスを引き出してレピュテーション判断を行う場合は、伝統的なCクラスホスト数ではなく、現代のCIDRセマンティクスを明確に使う必要があります。「Cクラスには254個のIPがある」という文脈は一般に使用可能なホスト数を指し、リスクカバレッジの統計母集団とは異なります。
カバレッジ、サンプル比率、全セグメントの既知ラベル比率
/24ページに3つの異なるパーセンテージが現れる場合、重要なのは各数値の分母を明らかにすることです。第一歩:カバレッジ。この/24で最近3アドレスのみ観測されたとします。分母は256、分子は3なので、カバレッジは3÷256=1.171875%です。これは「この期間にこのプレフィックス内のどの程度の割合のアドレスを見たか」という問いに答えるもので、「どれだけの問題アドレスがあるか」ではありません。この数値が低いことは、観測量が少ないことを示すだけで、残りのアドレスがクリーンか危険かを示すものではありません。
第二歩:観測サンプルのラベル比率。分子は観測された3アドレスのうちラベル付きの数、分母は観測された3アドレスです。3つすべてにラベルがあれば、結果は100%です。これは「すでに見られた少数のサンプルのうち、いくつにリスク注釈があるか」に答えます。これは条件付き比率であり、全セグメントの比率ではありません。その限界は、分子も分母も観測ウィンドウ、データソース、ラベル更新頻度に依存し、256アドレス全体のリスク率を表せないことです。
第三の指標は全セグメントの既知ラベル比率です:分子は既知のラベル付き3アドレス、分母は256で、1.171875%、約1.17%となります。この例では残り253アドレスは未観測であり、問い合わせたがヒットしなかったものとして扱うことはできません。3/256は256アドレスのうち3つが既知のラベル付きであることを示し、「256個のうち約1.17個」と書くことはできません。これは依然としてラベルカバレッジであり、実際の悪意率ではありません。なぜなら、ラベル自体がホスティング、VPN、Torなどの用途を記述するだけかもしれないからです。
未知のアドレスを安全または悪意に分類してはいけない
253個の未ラベルアドレスは異なる状態に分解する必要があり、「安全」または「有罪」と一括りにしてはいけません。未観測、一致なし、データ失敗、期限切れの4種類はページ注釈で意味が異なります。未観測は、最近センサー、クエリ、トラフィックイベントがこれらのアドレスを見ていないことを示します。一致なしは、問い合わせたがデータベースに対応するエントリがないことを示します。データ失敗は、タイムアウト、形式、または上流ソースの利用不能などの理由でクエリが結果を得られなかったことを示します。期限切れは、かつてラベルがあったが時間枠から外れたか、記録が無効になったために表示されなくなったことを示します。
これらの違いを理解することは、読者がリスクを判断する上で重要です。例えば、あるアドレスのRDAP、BGP、またはRPKI ROAのクエリがタイムアウトした場合に生じる「不明」と、ポートスキャンで一度もヒットしたことがない「未観測」とでは信頼性が異なります。前者は一時的な障害の可能性があり、後者は単に露出していないだけかもしれません。しかし、いずれにせよ「不明」は安全を意味しません。未ラベルを「検証済み安全」と言うのはリスクを過小評価し、未ラベルを「潜在的に悪意がある」と言うのは脅威を過大評価します。正しいアプローチは、ページ上のデータソースと評価方法リンクを確認し、データの更新頻度、ラベルの出所、重複排除ルール、時間枠を確認することです。
リスク評価の際には、未ラベルのアドレスを個別に観察待ち状態に分類し、直接脅威スコアに組み込まないようにすべきです。成熟した運用チームは、観測カバレッジ、ラベル比率、ラベル更新時刻を同時に追跡し、データベースの障害やカバレッジ不足に対してアラートを発します。例えば、/24内の253件のアドレスがすべて未観測の場合、セキュリティチームがこれをゼロリスクと見なすと、潜伏する悪意のあるインフラを見逃す可能性があります。一方、すべてをブラックリストに載せると、大量の誤検知が発生します。不明と既知のネガティブデータを区別することが、IPレピュテーション全体を識別する第一歩です。
観測サンプルには選択バイアスが存在する可能性があります
これらのサンプルが代表的かどうかは、収集方法によって異なります。サンプルがアラート、通報、IOC、ユーザーからの能動的なクエリに由来する場合、異常や疑いを引き起こしたアドレスがコレクションに入りやすく、注目されていないアドレスはあまり現れません。データがどのようにシステムに入るかをまず理解し、サンプリングの説明がないまま、全範囲からランダムに選ばれたと想定してはいけません。同じサンプル数でも、ランダムサンプリングとアラートトリガー収集とでは、支持される結論が異なります。
収集チャネルが異常イベントに偏っている場合、サンプルのラベル比率を全範囲に直接外挿するとリスクを過大評価する可能性があります。他の収集バイアスも異なる方向の誤差を生むことがあります。3つのサンプルすべてにラベルがあるからといって、それは現在のソースにおけるこれら3つのサンプルの状態を記述できるだけです。全体の推定値、信頼区間、誤差範囲を報告するには、サンプリング設計、ラベル定義、モデルの仮定を明確にする必要があり、100%という数字だけで一見正確な全範囲の安全結論を計算することはできません。
これが、少ないサンプルでIPレンジ全体の結論を下してはいけないと繰り返し強調する理由です。攻撃者は小さなホスティングIPブロックを借りてスキャンを仕掛けることができ、同じ/24内のほとんどのアドレスは正規のクラウドテナントに属する可能性があります。あるいは、ある/24内の3台のホストがボットネットに制御され、隣接アドレスは無傷であることもあります。サンプルバイアスにより、ページ上の100%のラベル比率は、全範囲のリスク確率というより、むしろアラートのリマインダーのように見えます。読者がこのような比率を解釈する際には、データの収集方法、イベントの重複排除ロジック、アクティブな時間枠を確認し、選択バイアスを全体の法則と誤解しないようにすべきです。
まず用途ラベルと行動記録を区別する
たとえ少数のアドレスに実際にラベルが付いていても、すべてのラベルを悪意のある侵入と同一視してはいけません。VPN、Tor、プロキシ、ホスティングは用途や展開方法の手がかりであり、例えばそのアドレスは公共VPNサービスが使用する出口IPである可能性があります。VPNとTorはそれ自体合法的なプライバシーツールであり、多くの一般ユーザーが毎日それらを通じてインターネットにアクセスし、商業機関もプロキシ出口を通じてトラフィックを転送します。したがって、このようなラベルは「悪意のある行為の断定」というより「インフラの特徴」に近いものです。
一方、悪意のあるスキャン報告、ブルートフォース試行、C2通信などは行動ベースのラベルであり、通常はセキュリティ機器や第三者ソースから得られます。両者の重み付けと誤検知リスクは異なります。ホスティングIPは、攻撃者もクラウドホストやプロキシ出口を借りることがあるため、VPN、プロキシ、スキャン元として同時にタグ付けされることがよくありますが、これらのインフラには多くの正当な用途もあります。ホスティングやプロキシという分類だけで、あるアクセスを悪意のあるものと判断することはできません。重複したソースや履歴エントリを独立した証拠として扱うことはできません。同じアドレスが10のインテリジェンスインターフェースで引用されていても、10の独立したイベントを意味するわけではなく、単に同じデータソースの伝播コピーである可能性が高く、重複カウントにつながりやすくなります。VPNを使っていないのにプロキシ判定される原因と確認方法から、VPNやプロキシのラベルがなぜ直接ブロックの根拠として使えないのかを理解できます。
実際の運用では、ラベルの種類、初回検出時刻、証拠ソース、重複排除識別子を区別する必要があります。例えば、ホスティングプロバイダーからの「Tor出口」ラベルのみのアドレスは、ドメインコントローラのアラートからの「横方向移動スキャン」ラベルが付いたアドレスと同等に扱うべきではありません。前者のリスクは主に匿名トラフィックの監査困難性に起因しますが、後者は内部侵入の兆候に直接関連します。ページが両方を「高リスク」としてパーセンテージで表示すると、読者は/24全体をブロックする必要があると誤解してしまいます。ラベルの意味を理解して初めて、ネットワークセグメントのリスクを合理的な範囲に抑えることができます。
同一ネットワークセグメント、ASN、テナントは同一ではありません
/24セグメントには256個のIPv4アドレスが含まれ、.0から.255までであり、通常言われる254個の利用可能なホストアドレスではありません。この違いは歴史的な理由から来ています。初期のクラスフルネットワークでは、クラスCアドレスのデフォルトサブネットマスクは255.255.255.0であり、ネットワークアドレスとブロードキャストアドレスはホストに割り当てられませんでした。現代のCIDR展開では、/24は単にプレフィックス長であり、ネットワークアドレスとブロードキャストアドレスの役割を自動的に分割するわけではありませんが、多くの通信事業者やクラウド環境では、/24は依然として割り当てまたは管理単位としてよく使用されます。したがって、/24セグメントを観察する場合、統計の分母は254ではなく、全256アドレスであるべきです。そうしないと、サンプルカバレッジを過大評価し、未知の部分を過小評価することになります。
アドレスが隣接しているからといって、同一テナントであるとは限りません。同じ /24 内の 2 つの IP が、まったく異なる顧客に割り当てられている場合もあれば、同じクラウドテナント配下の異なる仮想マシンに属している場合、さらには異なる時期に異なるユーザーによって使用されている場合もあります。同じ ASN であることは、これらのアドレスが同じ自律システムを通じて広報されていることを示すにすぎず、この AS は大規模なクラウドプロバイダーや通信事業者である可能性があり、何千もの独立した顧客にサービスを提供しています。同じ BGP プレフィックスであることは、ルーティングテーブル上の 1 つの集約を示すにすぎず、実際の割り当てはより細かくなっている可能性があります。例えば、1 つの /20 が複数の /24 に分割され、異なる部門や下流に割り当てられている場合があります。したがって、ある IP が悪性とマークされたからといって、同じセグメント内の他の IP もリスクがあると推測することはできません。
実際の BGP 広報は /20 である可能性もあれば、より具体的なプレフィックスが存在する可能性もあります。/24 はレピュテーションページでは多くの場合、単なる統計ウィンドウにすぎません。攻撃活動に含まれるのがそのうちのいくつかのアドレスであるからといって、残りのアドレスが安全であるとか悪性であるとかを証明することはできません。IPプレフィックス検索 と BGP経路検索 を使用して、ページで提供されているルート範囲と観測値を照合し、さらに RDAP で登録範囲を確認することができます。各ツールが提示するオブジェクトと粒度は異なる可能性があるため、ルート集約をそのままテナントの境界として扱うことはできません。
時間枠がどのように全体像を変えるか
アドレス範囲のリスク評価は、定められた期間内の観測データに依存します。ある/24で直近7日間に観測されたアドレスが3件だけで、その3件すべてに悪意のある活動のラベルが付き、残り253件には観測記録がないと仮定します。この場合、観測カバレッジは3/256、約1.17%です。観測済みアドレス内のラベル率は100%ですが、範囲全体に占める既知のラベル付きアドレスの割合は1.17%です。この計算は「観測されたのは3件だけ」という前提に依存します。「ラベル付きが3件、ラベルなしが253件」という情報だけでは、同じカバレッジを算出できません。照会して一致がなかったアドレスと、未観測のアドレスは別の状態です。また、これらの数値から残りのアドレスの安全性を判断することはできません。
時間枠は比率に影響します。サービスプロバイダが最近不正利用リソースを一掃した場合、悪意のあるIPはオフラインになり、ラベルも消えることがあります。テナントが移行すると、以前マークされていたIPが正常なユーザーに再割り当てされる可能性があります。観測が一時停止されたり、データソースの更新が遅れたりすると、サンプル数は減少します。これらの変化により、ある時点のサンプル比率はよりクリーンまたはよりダーティに見えることがありますが、それは実際のリスクの変化を意味するわけではありません。したがって、異なる時点のデータを比較する際には、時間枠と更新時刻が一致していることを確認する必要があります。
当サイトがインターネットIPの何パーセントをカバーしているかは主張できません。統一された観測全体集合が存在しないためです。少数のサンプルに基づくネットワークセグメントのプロファイルは、いずれも部分的なスナップショットにすぎません。ユーザーが特定の /24 セグメント内でラベルが消えたのを目にした場合、そのセグメントに新しい観測記録があるか、データソースが更新されているかを確認すべきであり、直接的に安全性が向上したと考えるべきではありません。
運用上のトラブルシューティング:まず対象アドレスの直接証拠を確認する
アラートを受信したら、まず対象IP自体のイベント証拠を確認します。例えば、タイムスタンプ付きのフローログ、アプリケーションリクエスト、セキュリティ機器の記録、検証可能なリストエントリなどです。RDAPとBGPは登録情報とルーティングの背景を提供するものであり、悪意のある行為の直接的な証拠ではありません。パッシブDNSの関連付けも、時間と用途を確認する必要があります。隣接IPのラベルは、さらなる調査のためのコンテキストとしてのみ使用でき、対象アドレス自体の証拠の代わりにはなりません。また、ASNの変化のみからテナントが既に変更されたと推測することもできません。
少数のラベル付き隣接IPが自動的にブロックを引き起こすわけではありません。例えば、ある /24 セグメント内の5つのIPが悪意のあるものとしてマークされている場合、これら5つのIPは同じ攻撃組織のノードである可能性もあれば、異なる顧客がそれぞれ侵害された可能性もあります。対象IPに悪意のある行為の証拠が一切ない場合、同じセグメントに悪意のある隣接IPが存在するというだけでブロックすると、正常なユーザーを誤ってブロックする可能性があります。証拠を記録し、サンプルカバレッジを注記し、レビュー責任者を指定して定期的に再確認する必要があります。
別の仮想シナリオを見てみましょう。ある /20 セグメント内で、1つの /24 セグメント内に行動ラベル付きのIPが3つ観測され、残りの253のアドレスには観測データがありません。3つのラベルが似ているように見えても、同一ソースからの重複伝播である可能性があり、3つの独立したイベントではないかもしれません。次のステップでは、エントリのソース、時間、および対象アドレス自体の記録を確認し、まだ未知のテナント関係を保持する必要があります。これは判断の順序を示す例であり、実際のネットワークセグメントの測定を表すものではありません。
調達時にベンダーに何を尋ねるべきか?
ネットワークサービスやIPインテリジェンスを調達する際、ベンダーが主張する「純粋度」だけを見てはいけません。データソースが何であるか、自社構築のハニーポットなのか、サードパーティのブラックリストなのか、それともパッシブDNSなのかを尋ねる必要があります。更新時間はリアルタイムか、毎日か、毎週か。カバレッジ分母はどれくらいか、全256アドレスを含むかどうか。具体的なエントリをエクスポートして検証できるかどうか。ベンダーがこれらの詳細を提供できない場合、その「純粋」という約束は信頼できません。
「100パーセント安全」「完全にクリーン」といった保証をうのみにしないでください。どの種類のネットワークでも、過去の不正利用や共有出口に伴う問題は起こり得ます。住宅用ネットワークの端末がマルウェアに感染することも、「ネイティブ」として販売されるIPアドレスが利用者に悪用されることもあります。提供元が示せるのは自らの観測に基づく統計であり、それだけで絶対的な安全性を保証することはできません。誤判定の修正手順、処理にかかる見込み時間、異議申し立て窓口を確認し、サービス上の約束と検証済みの事実を区別しましょう。
住宅、モバイル、ホスティングといった分類は異なるネットワーク背景を表しますが、カテゴリから直接どちらが悪意を持ちやすいかを推測することはできません。動的割り当て、共有利用、データカバレッジ、対象サービスポリシーが実際の体験に影響します。住宅用IP・ISPホスティングIP・データセンターIPの違いを読む際は、マーケティングラベルを検証可能なアクセス、用途、割り当て条件に分解し、具体的なビジネスシナリオの受け入れ基準をあらかじめ定めるべきです。
ネットワークセグメントのプロファイルを誤解なく提示するには?
開発者がネットワークセグメントプロファイルのインターフェースを設計する際は、総アドレス数(例:/24は256)、観測アドレス数、ラベル付きアドレス数、未知アドレス数を同時に表示する必要があります。これによりサンプルカバレッジを直感的に確認できます。例えば、観測3アドレス、ラベル3、未知253の場合、「カバレッジ1.17%、既知ラベル1.17%」と表示します。悪意ラベルの割合だけを表示するとユーザーを誤解させるため避けてください。
色の凡例は正常、悪意、不審、データなしなど、異なる用途と行動を区別する必要があります。データなしは安全と混同してはならず、灰色で未知を示すことができます。IPv6を表示するために、1つのセルが1つのIPを表す/24グリッド図を使用してはいけません。IPv6 /64は2^64個のアドレスがあり、256個のセルにマッピングできないためです。代わりに集計統計やサンプリング可視化を用いることができます。
CIDR計算ツールを使用すると、プレフィックスが含むアドレス数をすばやく確認できます。IPv6では、表示の際に「1つの/64内の隣接アドレスが同じテナントである」という誤解を示唆しないよう注意してください。例えば、IPv6では1つの/64は通常1つのサブネットに割り当てられますが、同じサブネット内に複数のコンテナや仮想マシンが存在する場合があります。
よくある質問とチェックリスト
1つのアドレスの異常が隣接アドレスに影響するかは、対象サービスが単一IP、プレフィックス、ASN、その他のシグナルのいずれでルールを実装しているかによります。多数のウェブサイトがどの方式を採用しているかを根拠なく断言することはできません。ラベルがゼロであることは、特定のデータとルールの下で一致する項目がないことを示すだけで、安全性を証明するものではありません。全256アドレスを観測したとしても、すべてにラベルがあるとは限りません。たとえ各アドレスにある種のラベルが付いていても、同一人物がセグメント全体を管理しているとは証明できません。カバレッジ、ラベルの意味、利用者の帰属は3つの独立した問題です。
チェックリストには、総アドレス数、観測アドレス数、ラベル付きアドレス数、未知アドレス数、時間枠、データソース、BGPプレフィックス、RDAP登録情報が含まれます。これらを確認した上で意思決定を行ってください。1つの数字だけを見て結論を出してはいけません。
さらに詳しい情報はIPレピュテーションの確認方法:リスクスコアとブロックリストとRDAP・ASN・BGP・RPKIで分かること:IP検索データの読み方をご参照ください。この2つのガイドは、IPの直接的・間接的な証拠を収集して解釈する方法を理解し、少数のサンプルをIPセグメント全体のレピュテーションと誤認することを避けるのに役立ちます。