Tres muestras con etiqueta, ¿por qué no significa que todo el bloque sea riesgoso?
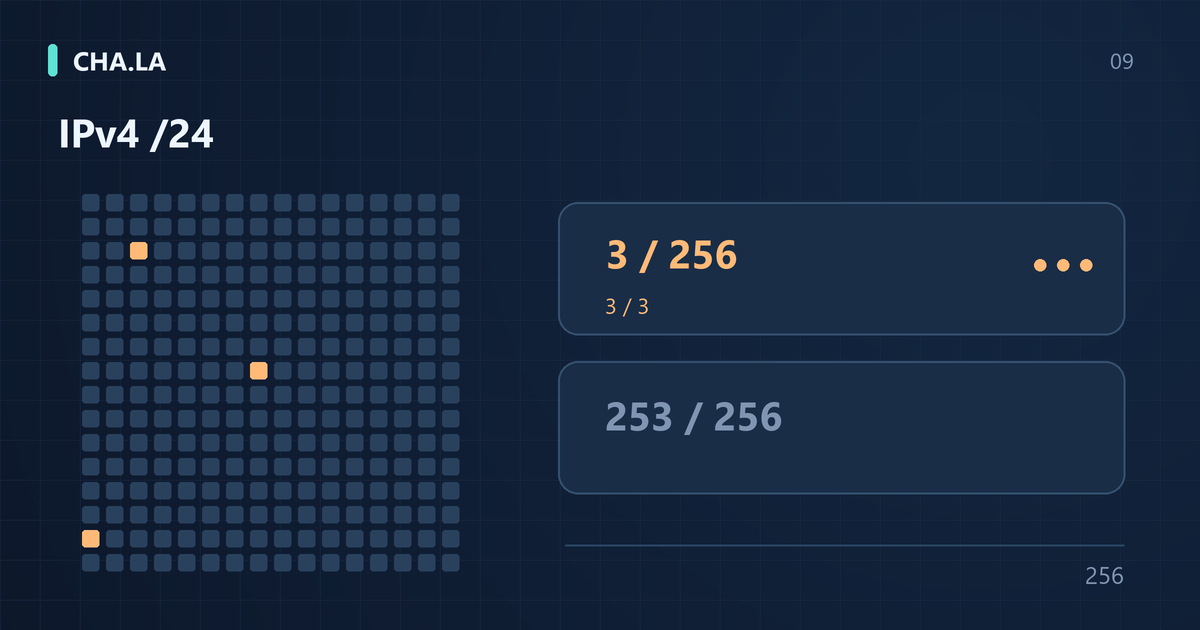
Supón que en la página de Consulta de IP ves una vista resumida de una red /24: solo se observaron 3 direcciones IPv4 recientemente y las 3 tienen etiquetas de riesgo, la interfaz puede mostrar "100% marcadas". Es un número fácil de malinterpretar, pero solo indica que todas las direcciones de la muestra observada están etiquetadas, no que las 256 direcciones del /24 sean maliciosas. Aclaramos que esto es solo un ejemplo de cálculo, no una medición de una red real. En la proporción de muestra del 100%, el numerador son las 3 direcciones observadas y el denominador también son las 3 direcciones observadas; al dividir se obtiene 100%, pero el denominador no incluye las 253 direcciones no observadas de ese /24.
Este error proviene de tomar "la parte observada" por "el todo". Muchos paneles de seguridad, plataformas de inteligencia de amenazas o interfaces de alertas de enrutamiento muestran por defecto las entradas aparecidas en una ventana de tiempo dada; las direcciones fuera de esa ventana, sin tráfico o no detectadas por sensores no aparecen en el numerador ni alteran el 100%. Mientras haya muchas direcciones no observadas, el porcentaje de la página no permite inferencias sobre todo el bloque. Al ver un 100% de etiquetas, confirma primero si hay una nota como "basado en observaciones recientes" o "cobertura de muestra".
En otras palabras, que esas 3 direcciones tengan etiquetas solo indica que las 3 vistas recientemente tienen anotaciones de seguridad. No se puede extrapolar que todo el bloque /24 sea de alto riesgo, ni afirmar que esas 3 sean fuentes de ataque maliciosas. Por ejemplo, las 3 podrían provenir de un nodo de salida Tor, con historial de escaneos reportados, mientras que las otras 253 direcciones del mismo /24 nunca generaron alertas. Si confundes "toda la muestra observada tiene etiqueta" con "todo el bloque tiene etiqueta", atribuyes comportamientos de pocos a la reputación de todo el bloque; ese es el sesgo central que analizamos aquí.
¿Por qué /24 y no red clase C?
Con el enrutamiento entre dominios sin clases (CIDR), /24 indica que los primeros 24 bits son el prefijo de red y los 8 restantes la parte de host, por lo que el prefijo contiene 2 elevado a 8, es decir, 256 direcciones, desde a.b.c.0 hasta a.b.c.255. Tradicionalmente se llama red clase C a un /24, pero es una denominación heredada. Antes de CIDR, IPv4 se dividía en clases y la máscara predeterminada de clase C era 255.255.255.0, igual en apariencia a /24, pero con diferencias importantes en el contexto moderno de enrutamiento y estadísticas.
Según el RFC 4632, CIDR ya no depende de los límites de clase A/B/C; cualquier longitud de prefijo puede anunciarse y agregarse. En la práctica, los prefijos de enrutamiento no suelen ser /24 exactos; por ejemplo, una organización puede anunciar un /20, que abarca 16 /24 consecutivos, y una actualización BGP o un ROA RPKI puede tener una longitud mayor o menor. Por lo tanto, tratar un /24 como frontera de red independiente no siempre refleja la topología real. Que direcciones vecinas estén en el mismo /24 no implica que pertenezcan a la misma subred física, al mismo inquilino o al mismo prefijo de ruta.
En estadística hay otra confusión común: en el cálculo tradicional de subredes, un /24 tiene 254 hosts utilizables, porque .0 se suele considerar dirección de red y .255 de difusión. Pero en inteligencia de amenazas, al evaluar la cobertura o la proporción de etiquetas de todo el prefijo /24, el denominador debe ser el conjunto completo de direcciones CIDR, es decir, 256, incluyendo .0 y .255. Si usas 254 como denominador, sobreestimas ligeramente la cobertura; y si evalúas la reputación de las 256 direcciones, debes aplicar la semántica CIDR moderna, no el número de hosts de clase C. Cuando alguien dice "una clase C tiene 254 IP", se refiere a hosts utilizables, no al universo estadístico de cobertura de riesgo.
Cobertura, proporción de muestra y proporción de etiquetas conocidas en todo el bloque
Cuando una página de /24 muestra tres porcentajes distintos, la clave es identificar el denominador de cada uno. Primer paso: cobertura. Supón que en ese /24 solo se observaron 3 direcciones; el denominador es 256, el numerador 3, la cobertura es 3÷256=1,171875%. Responde a "¿qué porcentaje de direcciones de este prefijo vimos en este período?", no a "cuántas direcciones tienen problemas". Un número bajo solo indica poca observación, no que el resto esté limpio o sea peligroso.
Segundo paso: proporción de etiquetas en la muestra observada. El numerador es el número de direcciones observadas con etiqueta (3) y el denominador las direcciones observadas (3). Si las 3 tienen etiqueta, el resultado es 100%. Responde a "de las pocas muestras vistas, ¿cuántas tienen anotaciones de riesgo?". Es una proporción condicional, no del bloque completo. Su limitación es que numerador y denominador dependen de la ventana de observación, las fuentes de datos y la frecuencia de actualización de etiquetas; no representa la tasa de riesgo global de las 256 direcciones.
El tercer indicador es la proporción de etiquetas conocidas en todo el bloque: el numerador son las 3 direcciones con etiqueta conocida, el denominador 256, lo que da 1,171875%, aproximadamente 1,17%. En este ejemplo hay 253 direcciones no observadas; no se pueden tratar como "consultadas sin coincidencia". 3/256 significa que de 256 direcciones, 3 tienen etiqueta conocida; no se escribe "aproximadamente 1,17 de 256". Sigue siendo cobertura de etiquetas, no una tasa real de malicia, porque las etiquetas pueden describir usos como hosting, VPN o Tor.
Las direcciones desconocidas no son seguras ni maliciosas
Las 253 direcciones sin etiqueta deben separarse en estados distintos, no agruparse como "seguras" o "culpables". No observado, sin coincidencia, error de datos y caducado tienen significados diferentes en las notas de la página. No observado significa que ningún sensor, consulta o evento de tráfico reciente vio esas direcciones; sin coincidencia, que se consultaron pero la base de datos no tiene una entrada; error de datos, que la consulta no obtuvo resultado por tiempo de espera, formato o indisponibilidad de la fuente; caducado, que hubo una etiqueta pero ya no se muestra por salir de la ventana temporal o por invalidación del registro.
Comprender estas diferencias es importante para que el lector evalúe el riesgo. Por ejemplo, si una consulta de dirección agota el tiempo de espera en RDAP, BGP o RPKI ROA, el "desconocido" resultante tiene una fiabilidad distinta del "no observado" de una dirección que nunca ha sido alcanzada por un escaneo de puertos. El primero podría ser una falla temporal; el segundo, simplemente falta de exposición. Pero en cualquier caso, "desconocido" no equivale a seguro. Afirmar que lo no etiquetado está "verificado como seguro" subestima el riesgo, mientras que decir que es "potencialmente malicioso" lo sobreestima. El enfoque correcto es revisar el enlace Fuentes de datos y metodología en la página para confirmar la frecuencia de actualización de los datos, el origen de las etiquetas, las reglas de deduplicación y la ventana temporal.
Al evaluar riesgos, las direcciones sin etiquetar deben clasificarse por separado en un estado de observación pendiente, en lugar de incorporarse directamente a la puntuación de amenazas. Los equipos operativos maduros realizan un seguimiento simultáneo de la cobertura de observación, la proporción de etiquetas y el momento de actualización de las etiquetas, y activan alertas ante fallos de la base de datos o cobertura insuficiente. Por ejemplo, si en un /24 hay 253 direcciones sin observar y el equipo de seguridad lo considera de riesgo cero, podrían pasar por alto infraestructura maliciosa latente; si, por el contrario, incluyen todo el bloque en una lista negra, generarán numerosos falsos positivos. Distinguir entre lo desconocido y los datos negativos conocidos es el primer paso para identificar la reputación de IP de todo un rango.
Las muestras observadas pueden tener sesgo de selección
Que estas muestras sean representativas depende del método de recolección. Si provienen de alertas, denuncias, IOC o consultas activas de usuarios, es más probable que las direcciones anómalas o sospechosas entren en el conjunto, mientras que las no vigiladas aparecen con menos frecuencia. Primero hay que entender cómo ingresan los datos al sistema; no se puede asumir por defecto que son una selección aleatoria de todo el rango sin una descripción del muestreo. Con el mismo número de muestras, las conclusiones que respaldan el muestreo aleatorio y la recolección activada por alertas no son iguales.
Si los canales de recolección están sesgados hacia eventos anómalos, extrapolar directamente la proporción de etiquetas de la muestra a todo el rango puede sobreestimar el riesgo; otros sesgos de recolección también pueden producir errores en direcciones distintas. Que las tres muestras tengan etiqueta solo describe el estado de esas tres muestras en la fuente actual. Para informar de una estimación poblacional, un intervalo de confianza o un margen de error, es necesario especificar el diseño de muestreo, la definición de las etiquetas y los supuestos del modelo; no se puede calcular una conclusión de seguridad aparentemente precisa para todo el rango basándose únicamente en la cifra del 100%.
Por eso insistimos en no sacar conclusiones sobre todo un rango de IP a partir de pocas muestras. Un atacante puede alquilar un pequeño bloque de IP alojadas para lanzar escaneos, mientras que la mayoría de las direcciones del mismo /24 pueden pertenecer a inquilinos legítimos de la nube; o tres hosts de un /24 están controlados por una botnet mientras que las direcciones vecinas están intactas. El sesgo de la muestra hace que la proporción de etiquetas del 100% en la página se parezca más a una alerta que a una probabilidad de riesgo de todo el rango. Al interpretar estas proporciones, el lector debe verificar el método de recolección de datos, la lógica de deduplicación de eventos y la ventana temporal activa, para evitar confundir el sesgo de selección con una regularidad poblacional.
Primero distingue entre etiquetas de uso y registros de comportamiento
Aunque unas pocas direcciones tengan etiquetas, no todas las etiquetas equivalen a una intrusión maliciosa. VPN, Tor, proxy y alojamiento son pistas de uso o de forma de despliegue; por ejemplo, esa dirección puede ser una IP de salida utilizada por un proveedor de VPN público. VPN y Tor son herramientas de privacidad legítimas en sí mismas; muchos usuarios comunes acceden a Internet a través de ellas cada día, y las organizaciones comerciales también reenvían tráfico mediante salidas de proxy. Por lo tanto, estas etiquetas se inclinan más hacia "características de infraestructura" que hacia "calificación de comportamiento malicioso".
En cambio, los informes de escaneo malicioso, los intentos de fuerza bruta y la comunicación C2 son etiquetas de tipo conductual, que suelen proceder de dispositivos de seguridad o fuentes de terceros. El peso y el riesgo de falsos positivos de ambas son diferentes. Las IP alojadas a menudo se marcan simultáneamente como VPN, proxy y origen de escaneos, porque los atacantes también alquilan hosts en la nube o salidas de proxy, pero estas infraestructuras también tienen muchos usos legítimos; el alojamiento o el uso de un proxy no demuestran por sí solos que una solicitud sea maliciosa. Las fuentes repetidas y los registros históricos no pueden considerarse evidencia independiente: que diez interfaces de inteligencia citen la misma dirección no equivale a diez eventos independientes; probablemente sea solo una copia propagada de la misma fuente de datos, lo que provoca un conteo duplicado. Puedes consultar Tu IP aparece como VPN o proxy: cómo revisar un falso positivo para entender por qué las etiquetas de VPN o proxy no pueden usarse directamente como base para bloquear.
En la operación real, hay que distinguir el tipo de etiqueta, la fecha de primera detección, la fuente de evidencia y el identificador de deduplicación. Por ejemplo, una dirección de un proveedor de alojamiento con solo la etiqueta "salida Tor" no debe tratarse igual que una de una alerta de controlador de dominio con la etiqueta "escaneo de movimiento lateral". El riesgo de la primera se debe más a que el tráfico anónimo es difícil de auditar; la segunda se asocia directamente a indicios de intrusión interna. Si la página clasifica ambas como "riesgo alto" y lo muestra con porcentajes, inducirá al lector a creer que todo el /24 necesita bloqueo. Comprender la semántica de las etiquetas permite mantener el riesgo del segmento de red en un rango razonable.
El mismo segmento de red, ASN y arrendatario no son lo mismo
Un segmento /24 contiene 256 direcciones IPv4, desde .0 hasta .255, no los 254 hosts utilizables que se suele decir. La diferencia proviene de razones históricas: en las primeras redes con clase, una dirección de clase C tenía máscara de subred por defecto 255.255.255.0, y las direcciones de red y de difusión no se podían asignar a hosts. En el despliegue CIDR moderno, /24 es solo una longitud de prefijo; no separa automáticamente los roles de dirección de red y de difusión, aunque en muchos entornos de operadores y nube un /24 se sigue usando a menudo como unidad de asignación o administración. Por lo tanto, al observar un segmento /24, el denominador estadístico debe ser las 256 direcciones completas, no 254. De lo contrario, se sobreestima la cobertura de la muestra y se subestima la parte desconocida.
La proximidad de direcciones no demuestra que pertenezcan al mismo arrendatario. Dos IP del mismo /24 pueden estar asignadas a clientes completamente distintos, o a diferentes máquinas virtuales de un mismo arrendatario de nube, o ser usadas por distintos usuarios en momentos diferentes. Un mismo ASN solo indica que esas direcciones se anuncian a través del mismo sistema autónomo; ese AS puede ser un gran proveedor de nube u operador que sirve a miles de clientes independientes. Un mismo prefijo BGP solo representa una agregación en la tabla de enrutamiento; la asignación real puede ser más fina, por ejemplo un /20 dividido en varios /24 para distintos departamentos o clientes descendentes. Por tanto, no se puede inferir que otras IP del mismo segmento tengan riesgo solo porque una IP esté marcada como maliciosa.
El anuncio BGP real puede ser un /20 o puede haber prefijos más específicos; el /24 en la página de reputación suele ser solo una ventana estadística. Que la actividad de ataque implique unas pocas direcciones no prueba que el resto sean seguras o maliciosas. Puedes verificar el rango de rutas y las observaciones proporcionadas por la página mediante Consulta de prefijos IP y Consulta de rutas BGP, y luego consultar el rango registrado por RDAP. Los objetos y la granularidad que presentan las distintas herramientas pueden diferir; no se puede tomar la agregación de rutas directamente como frontera entre arrendatarios.
Cómo cambia el perfil según la ventana temporal
El perfil de riesgo de un bloque depende de las observaciones dentro de una ventana temporal definida. Supón que, durante los últimos 7 días, solo se observaron 3 direcciones de un /24, las 3 tienen etiquetas de actividad maliciosa y las otras 253 no tienen registros de observación. La cobertura es entonces 3/256, aproximadamente el 1,17%; la proporción de etiquetas entre las direcciones observadas es del 100%, y la proporción de marcas conocidas sobre todo el bloque es del 1,17%. El cálculo depende de que solo se hayan observado 3 direcciones. No puedes deducir esa cobertura únicamente de que haya 3 direcciones etiquetadas y 253 sin etiqueta. Una dirección consultada sin coincidencias no equivale a una dirección nunca observada, y estos números no determinan si las demás son seguras.
La ventana de tiempo afecta las proporciones. Si un proveedor limpió recientemente recursos abusivos, las IP maliciosas pueden desaparecer y las etiquetas se eliminan; si un inquilino migra, las IP previamente marcadas pueden reasignarse a usuarios normales; si la observación se pausa o hay retrasos en las actualizaciones de fuentes, el tamaño de la muestra se reduce. Estos cambios hacen que la proporción de muestras en un momento dado parezca más limpia o más sucia, pero eso no equivale a un cambio real en el riesgo. Por lo tanto, al comparar datos de distintos momentos, hay que confirmar que la ventana de tiempo y la hora de actualización coincidan.
No podemos afirmar qué proporción de IP de Internet cubre este sitio, porque no hay un universo de observación unificado. Cualquier perfil de segmento basado en pocas muestras es solo una instantánea parcial. Cuando un usuario ve que las etiquetas desaparecen en un /24, debe revisar si hay nuevos registros de observación en ese segmento y si las fuentes se actualizaron, en lugar de asumir directamente una mejora de seguridad.
Resolución de problemas operativos: primero mira la evidencia directa de la dirección de destino
Al recibir una alerta, examina primero la evidencia de eventos de la IP de destino, como registros de flujo con marcas de tiempo, solicitudes de aplicaciones, registros de dispositivos de seguridad y entradas verificables de listas. RDAP y BGP proporcionan antecedentes de registro y enrutamiento, no evidencia directa de actividad maliciosa; las asociaciones de DNS pasivo también deben verificarse con tiempo y propósito. Las etiquetas de IP vecinas solo sirven como contexto para investigaciones adicionales, no reemplazan la evidencia de la dirección de destino, ni se puede inferir un cambio de inquilino solo por cambios de ASN.
Unos pocos vecinos etiquetados no disparan bloqueos automáticos. Supón que en un /24, 5 IP están marcadas como maliciosas; esas 5 IP pueden ser nodos de la misma organización atacante o clientes distintos comprometidos. Si la IP de destino no tiene evidencia de comportamiento malicioso, bloquearla solo por tener vecinos maliciosos en el mismo segmento puede dañar a usuarios normales. Debes registrar la evidencia, anotar la cobertura de la muestra y asignar un responsable de revisión para reevaluar periódicamente.
Veamos otro escenario hipotético: en un /20, dentro de un /24 se observan 3 IP con etiquetas de comportamiento, y otras 253 direcciones no tienen datos de observación. Aunque las tres etiquetas parezcan similares, pueden provenir de la propagación repetida de la misma fuente, no de tres eventos independientes. El siguiente paso es verificar el origen de las entradas, el tiempo y los registros de la dirección de destino, manteniendo la relación de inquilino aún desconocida. Este es un ejemplo para ilustrar el orden de juicio, no una medición de un segmento real.
¿Qué preguntar a los proveedores al comprar?
Al adquirir servicios de red o inteligencia de IP, no te fíes solo de la "pureza" declarada por el proveedor. Pregunta cuáles son las fuentes de datos: honeypots propios, listas negras de terceros o DNS pasivo; cuál es la frecuencia de actualización: en tiempo real, diaria o semanal; cuál es el denominador de cobertura, si incluye las 256 direcciones; y si las entradas específicas se pueden exportar y verificar. Si el proveedor no puede dar estos detalles, su promesa de "pureza" no es creíble.
No aceptes garantías de «pureza del cien por cien». Cualquier tipo de red puede tener antecedentes de abuso o problemas asociados a una salida compartida: los dispositivos de una red residencial pueden infectarse con malware, y los clientes también pueden usar indebidamente direcciones vendidas como «nativas». El proveedor puede ofrecer estadísticas basadas en sus observaciones, pero estas no garantizan una seguridad absoluta. Pide información sobre el proceso de corrección, el plazo previsto y el canal de reclamación, y distingue los compromisos del servicio de los hechos verificados.
Las clasificaciones como residencial, móvil y alojado describen distintos antecedentes de red; no se puede deducir directamente de la categoría cuál es más propensa a ser maliciosa. La asignación dinámica, el uso compartido, la cobertura de datos y las políticas del servicio de destino afectan la experiencia real. Al leer IP residencial, de ISP y de centro de datos: diferencias, descompón las etiquetas de marketing en condiciones verificables de acceso, uso y asignación, y luego acuerda criterios de aceptación para escenarios de negocio concretos.
¿Cómo presentar perfiles de segmentos sin inducir a error?
Al diseñar la interfaz de perfil de segmento, los desarrolladores deben mostrar simultáneamente el número total de direcciones (por ejemplo, 256 para un /24), direcciones observadas, direcciones etiquetadas y direcciones desconocidas. Así se ve intuitivamente la cobertura de la muestra. Por ejemplo, si se observan 3 direcciones, 3 etiquetadas y 253 desconocidas, se muestra como "cobertura 1,17%, etiquetas conocidas 1,17%". No muestres solo la proporción de etiquetas maliciosas, porque eso confunde a los usuarios.
La leyenda de colores debe distinguir distintos usos y comportamientos, como normal, malicioso, sospechoso y sin datos. Sin datos no debe confundirse con seguro; se puede usar gris para lo desconocido. No uses una cuadrícula /24 donde cada celda representa una IP para mostrar IPv6, porque un /64 de IPv6 tiene 2^64 direcciones, imposibles de mapear en 256 celdas. En su lugar, usa estadísticas agregadas o visualización por muestreo.
Usar la Calculadora CIDR permite confirmar rápidamente cuántas direcciones contiene un prefijo. Para IPv6, al mostrarlo evita sugerir el error de que "un vecino dentro de un /64 equivale a un inquilino". Por ejemplo, en IPv6, un /64 suele asignarse a una subred, pero dentro de la misma subred puede haber múltiples contenedores o máquinas virtuales.
Preguntas frecuentes y lista de verificación
Si la anomalía de una dirección afecta a los vecinos depende de si el servicio de destino aplica reglas por IP individual, prefijo, ASN u otras señales; no se puede afirmar sin fundamento qué enfoque usan la mayoría de los sitios. Cero etiquetas solo significa que no hubo coincidencias bajo datos y reglas específicos, no prueba seguridad. Observar las 256 direcciones no equivale a que todas tengan etiquetas; incluso si cada dirección tiene algún tipo de etiqueta, no prueba que una misma persona controle todo el segmento. Cobertura, significado de etiquetas y atribución de usuarios son tres cuestiones independientes.
La lista de verificación incluye: número total de direcciones, direcciones observadas, direcciones etiquetadas, direcciones desconocidas, ventana de tiempo, fuentes de datos, prefijo BGP e información de registro RDAP. Confirma estos antes de decidir. No saques conclusiones con un solo número.
Para más información, puedes usar el Reputación IP: cómo interpretar riesgos y listas negras y RDAP, ASN, BGP y RPKI: cómo interpretar una consulta de IP. Estas dos guías te ayudan a entender cómo recopilar e interpretar evidencia directa e indirecta de IP, y evitan que trates unas pocas muestras como la reputación de todo un segmento.